生态再分类模型 LightGBM/XGBoost 数据准备
说明生态再分类模型所需的生态标签、生态分区、Sentinel-2、DEM、HWSD、ESA WorldCover 与 JRC 水体等数据。
本文说明生态再分类模型所需的生态标签、生态分区、Sentinel-2、DEM、HWSD、ESA WorldCover 与 JRC 水体等数据。
本文说明生态再分类 LightGBM/XGBoost 模型所需的数据类型、数据作用和理论获取方式。写作口径限定为模型数据准备说明,不写服务器路径、脚本命令、具体运行日志或故障排查记录。
每类数据均按三个问题组织:
1. 数据介绍:该数据是什么,表达什么生态或地表信息。
2. 如何使用:该数据在模型训练、推理或后处理中承担什么角色。
3. 如何下载:从理论上应从哪个官方或开放数据源获取,下载时需要关注什么条件。
模型涉及的数据可以分为六类:
| 数据类型 | 代表数据 | 模型角色 |
|---|---|---|
| 生态分类标签 | 既有 90m 生态类型图 | 训练监督来源 |
| 生态分区 | R1-R9 生态区边界 | 分区训练、分区推理和区域模型选择 |
| 光学遥感 | Sentinel-2 Level-2A | 主要动态预测特征 |
| 地形 | DEM、坡度、坡向 | 稳定自然环境特征 |
| 土壤 | HWSD v2.0 | 土壤类型和理化属性特征 |
| 外部辅助数据 | ESA WorldCover、JRC Global Surface Water、EMC-BUILT | 样本 QA、辅助特征和后处理证据 |
生态分类标签数据
数据介绍
生态分类标签是模型训练的监督来源,通常来自已有生态分类成果。该数据记录每个空间单元所属的生态系统类型编码,是 LightGBM/XGBoost 学习分类关系的目标变量。对于本模型,标签侧关注的是三级生态类型编码,而不是普通土地覆盖大类。
由于原始生态分类标签通常与目标预测分辨率不同,不能简单把低分辨率标签重采样为高分辨率真值。标签数据的主要价值是提供可靠的类别监督,而不是直接作为最终 30m 产品。
如何使用
标签数据用于高置信度样本提取。理论上应先排除无效值、背景值和不属于终端分类层级的编码,再根据图斑内部性、邻域一致性、边界距离和空间去聚集等原则筛选训练样本。
标签侧质量控制的目的,是减少边界像元、混合像元和历史分类噪声对模型训练的影响。最终进入模型训练的不是整幅标签图,而是经过质量控制后的样本点及其生态类型编码。
生态分区数据
数据介绍
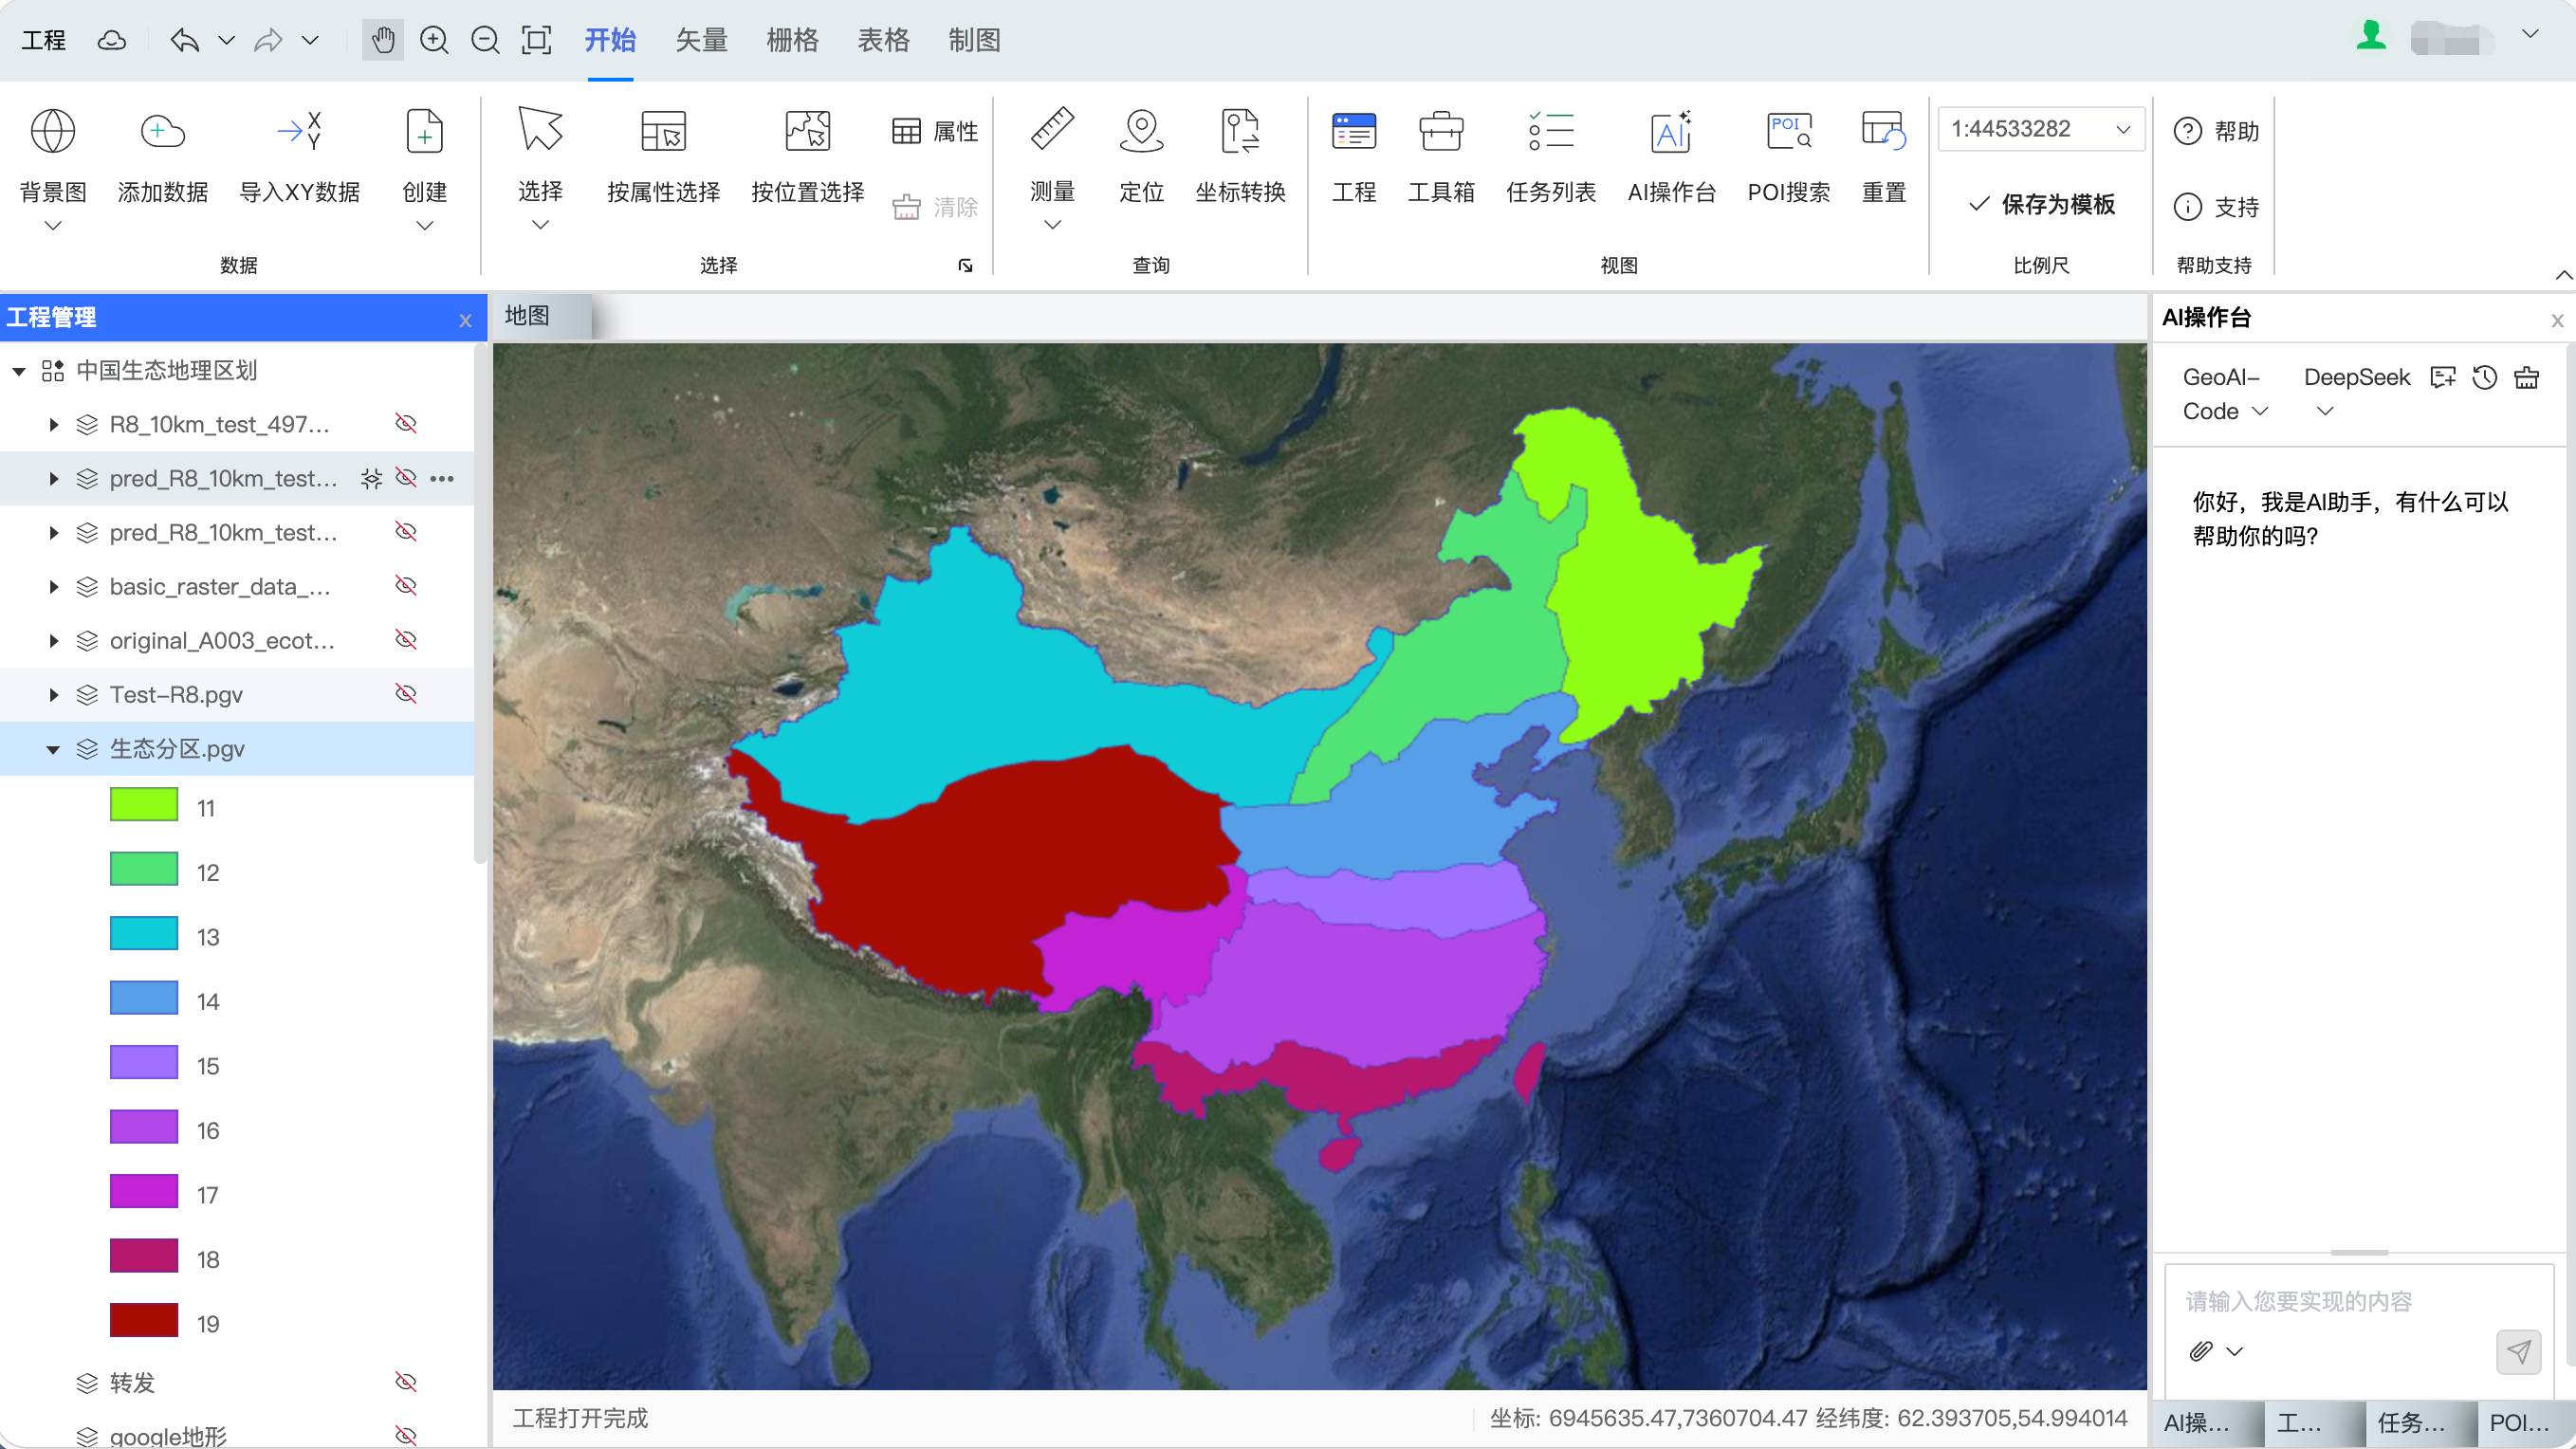
生态分区数据描述全国不同生态区的空间范围,例如 R1-R9 分区。它不是训练标签,而是表达区域生态背景差异的空间框架。同样的 Sentinel-2 光谱响应,在不同气候、地形和生态区内可能对应不同生态类型,因此生态分区对模型训练和模型选择非常重要。
如何使用
生态分区主要用于三类任务:第一,按生态区提取样本和统计类别分布;第二,训练 R1-R9 分区 LightGBM/XGBoost 模型;第三,在全国推理时根据像元或 tile 所属分区选择对应模型。
全国统一模型也可以使用生态分区信息,但其作用通常是作为 region_id 或区域类别特征,而不是裁剪边界。分区模型和全国统一模型的比较,应基于每区指标、类别级指标和空间连续性共同判断。
初步采用 9个生态—物候建模区:
| 建模区编号 | 建模区名称 | 对应生态地理区 |
|---|---|---|
| R1 | 东北寒温带—中温带森林与沼泽区 | ⅠA1、ⅡA1、ⅡA2、ⅡA3、ⅡB2 |
| R2 | 东北—内蒙古温带草原森林草原区 | ⅡB1、ⅡB3、ⅡC1、ⅡC2、ⅡC3、ⅡC4 |
| R3 | 西北干旱荒漠—绿洲区 | ⅡD1–ⅡD5、ⅢD1 |
| R4 | 华北暖温带农田—落叶阔叶林区 | ⅢA1、ⅢB1–ⅢB4、ⅢC1 |
| R5 | 北亚热带混交林—栽培植被区 | ⅣA1、ⅣA2 |
| R6 | 中亚热带常绿阔叶林—水田丘陵区 | ⅤA1–ⅤA5 |
| R7 | 西南山地—横断山森林灌丛区 | ⅤA6、HⅡA1、HⅡB1 |
| R8 | 南亚热带—边缘热带常绿林季雨林区 | ⅥA1、ⅥA2、ⅥA3、ⅦA1、ⅦA2、ⅦA3 ⅧA1、ⅨA1 |
| R9 | 青藏高原高寒草地—高寒荒漠区 | HI 系列、HⅡC1、HⅡC2、HⅡD1、HⅡD2 |
制作
根据论文提供的数据进行制作,制作过程见下篇文章。
Sentinel-2数据
哨兵卫星简介
哨兵卫星,即 Sentinel 系列卫星,是欧洲哥白尼计划中的核心对地观测卫星体系。该系列卫星面向长期、连续、稳定的地球观测需求建设,主要用于获取陆地、海洋、大气、冰雪、水体、植被和人类活动等方面的遥感数据。与传统单一遥感卫星不同,Sentinel 是一组任务系列,不同卫星搭载不同类型的传感器,分别服务于雷达成像、光学多光谱观测、海洋监测、大气监测和海平面监测等应用方向。
Sentinel 系列卫星的一个重要特点是数据开放程度高、覆盖范围广、重访周期稳定,适合用于大尺度、长时间序列的地表监测。由于其数据免费开放、标准化程度较高,目前已经广泛应用于土地覆盖分类、农作物监测、森林变化监测、水体提取、城市扩张分析、灾害监测、生态环境评估和气候变化研究等领域。
在 Sentinel 系列中,常用任务包括 Sentinel-1、Sentinel-2、Sentinel-3、Sentinel-5P 和 Sentinel-6 等。其中,Sentinel-1 是雷达卫星,搭载 C 波段合成孔径雷达,可以在夜间和多云天气条件下获取地表信息,常用于洪水监测、地表形变监测、海冰监测和土壤湿度相关分析。Sentinel-2 是光学多光谱卫星,搭载多光谱成像仪,能够获取可见光、红边、近红外和短波红外等多个波段,是陆地资源调查和生态环境监测中最常用的数据源之一。Sentinel-3 主要面向海洋和陆地综合监测,可用于海表温度、海色、陆表温度和大尺度环境变化分析。Sentinel-5P 主要用于大气成分监测,可观测臭氧、二氧化氮、二氧化硫、一氧化碳、甲烷和气溶胶等。Sentinel-6 则主要服务于海平面高度和海洋动力过程监测。
对于陆地生态、植被和土地覆盖分类而言,Sentinel-2 是最重要的哨兵卫星数据源。Sentinel-2 具有较高的空间分辨率和丰富的光谱信息,包含蓝、绿、红、红边、近红外和短波红外等关键波段。其中,10 米分辨率波段适合表达地表空间细节,20 米分辨率的红边和短波红外波段则对植被类型、植被长势、含水量、裸地和干湿差异具有较强区分能力。因此,在生态类型分类、植被群落识别、农田与林地分离、湿地识别和裸地监测等任务中,Sentinel-2 数据具有很高的实用价值。
在实际应用中,Sentinel-2 常使用 Level-2A 地表反射率产品。该产品已经经过大气校正,更适合进行时间序列分析、地物分类和生态环境建模。进行生态类型分类时,通常不会只使用单景影像,而是根据研究区的物候特征,构建春季、夏季、秋季等多时相合成影像。通过多季节影像,可以同时表达不同生态类型在生长季、旺盛期和衰退期的光谱差异,从而提高分类模型对林地、草地、农田、湿地、荒漠和裸地等类型的识别能力。
总体来看,哨兵卫星为现代遥感应用提供了稳定、开放、连续的数据基础。其中,Sentinel-2 凭借较高的空间分辨率、丰富的光谱波段和良好的重访能力,已经成为土地覆盖分类、生态类型制图和区域环境监测中最常用的遥感数据之一。
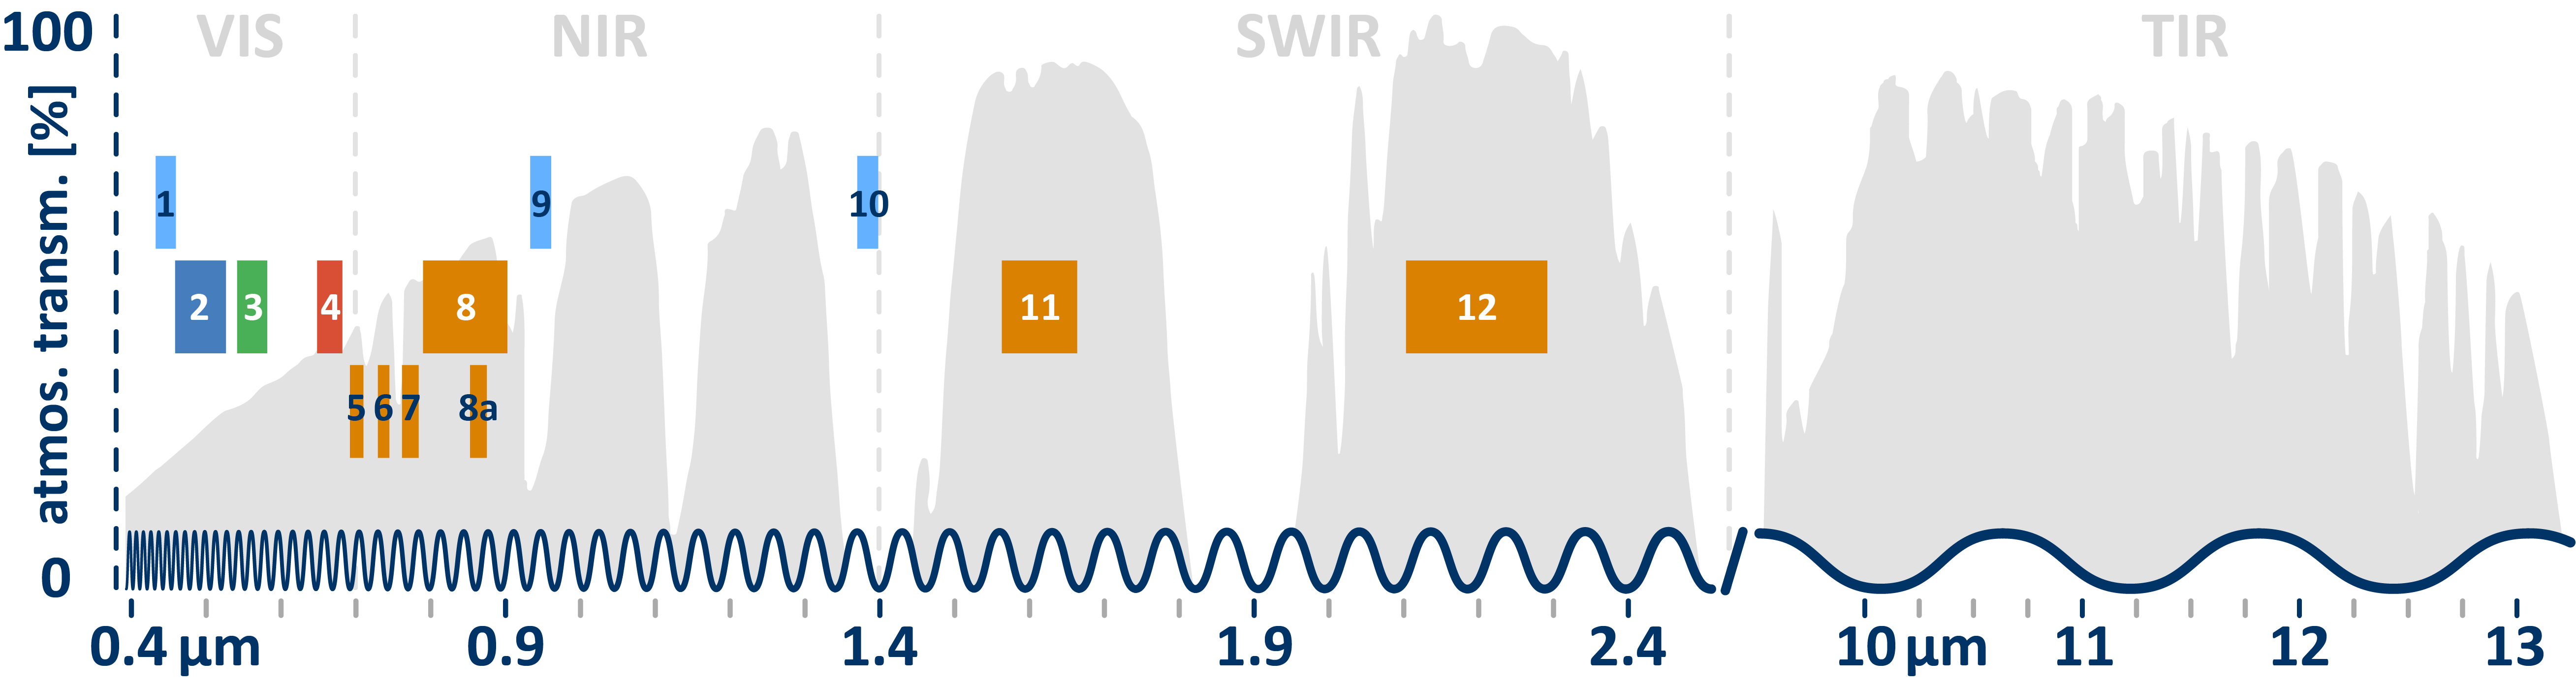
Sentinel-2 常用波段表
| 波段 | 名称 | 中心波长约值 | 原始分辨率 | 是否推荐 | 主要用途 |
|---|---|---|---|---|---|
| B1 | Coastal aerosol | 443 nm | 60 m | 可选 | 大气/气溶胶相关,对生态类型分类不是首选 |
| B2 | Blue | 490 nm | 10 m | 推荐 | 可见光蓝波段,辅助区分水体、裸地、建筑、阴影 |
| B3 | Green | 560 nm | 10 m | 推荐 | 可见光绿波段,反映植被绿度和水体差异 |
| B4 | Red | 665 nm | 10 m | 推荐 | 红波段,植被叶绿素吸收明显,是分类基础波段 |
| B5 | Red Edge 1 | 705 nm | 20 m | 强烈推荐 | 红边波段,对植被类型、长势、叶绿素差异敏感 |
| B6 | Red Edge 2 | 740 nm | 20 m | 强烈推荐 | 红边波段,增强林地、草地、农田等植被类型区分能力 |
| B7 | Red Edge 3 | 783 nm | 20 m | 强烈推荐 | 红边波段,对高覆盖植被和不同植被群落有帮助 |
| B8 | NIR | 842 nm | 10 m | 强烈推荐 | 近红外宽波段,植被和水体区分非常关键 |
| B8A | Narrow NIR | 865 nm | 20 m | 推荐 | 窄近红外,与红边/SWIR 组合有利于生态类型区分 |
| B9 | Water vapor | 945 nm | 60 m | 可选 | 水汽波段,通常不是生态分类核心输入 |
| B10 | Cirrus | 1375 nm | 60 m | 不推荐 | 主要用于卷云检测,通常不用于地物/生态类型分类 |
| B11 | SWIR 1 | 1610 nm | 20 m | 强烈推荐 | 短波红外,对植被含水量、土壤湿度、裸地差异敏感 |
| B12 | SWIR 2 | 2190 nm | 20 m | 强烈推荐 | 短波红外,对干湿差异、裸地、枯黄植被、烧毁地等敏感 |
波段组合介绍
1. 可见光波段B2、B3、B4
B2/B3/B4 对应蓝、绿、红三个可见光波段,是最基础的地表光谱信息。
作用:
- 区分水体、裸地、建设用地、植被和阴影。
- 与近红外组合可形成类似 NDVI 的植被差异信息。
- 保留人眼可解释的颜色信息,有助于模型学习基本纹理和色调。
局限:
- 只用 RGB 很难稳定区分森林、灌丛、草地、农田等生态类型。
- 受季节、土壤背景、阴影和大气影响较大。
结论:
B2, B3, B4 必选,但不能只选这三个。
2. 红边波段B5、B6、B7
Sentinel-2 相比很多普通光学影像的优势之一是具有多个红边波段。红边区域对植被叶绿素、冠层结构和植被生长状态非常敏感。
作用:
- 区分不同植被类型,如林地、灌丛、草地、农田。
- 对高覆盖度植被比普通红波段更敏感。
- 对生态类型中的植被群落差异有帮助。
适合场景:
- 森林、灌丛、草地、农田之间容易混淆时。
- 需要识别不同生态系统类型,而不是只做水体/裸地/植被粗分类时。
- 全国尺度或区域尺度生态分类任务。
结论:
B5, B6, B7 强烈建议加入。
3. 近红外波段B8、B8A
近红外是遥感生态分类中最重要的波段之一,是植被和水体区分核心信息。健康植被在近红外通常具有高反射,水体在近红外通常很低。
B8 是 10m 宽近红外波段,空间细节更好。
B8A 是 20m 窄近红外波段,与红边和 SWIR 配合更稳定。
作用:
- 区分植被和非植被。
- 区分水体、湿地和阴影。
- 与红波段、红边波段、SWIR 波段组合有助于识别生态类型。
结论:
B8 必选,B8A 推荐加入。
4. 短波红外B11、B12
短波红外用来区分湿度、裸地和植被状态,尤其适合区分植被含水量、土壤湿度、裸地、沙地、盐碱地、枯黄植被、湿地等。
作用:
- 区分水体、湿地、沼泽、河滩和潮湿土壤。
- 区分草地、农田、裸地、沙地、荒漠等类型。
- 识别枯黄植被、低覆盖植被和干旱区生态类型。
- 对中国西北、华北、青藏高原等干旱/半干旱区域尤其重要。
结论:
B11, B12 强烈建议加入。
常用波段组合
| 预设名称 | 英文名 | 波段 |
|---|---|---|
| 真彩色 | True Color | B4, B3, B2 |
| 标准假彩色 | Color Infrared | B8, B4, B3 |
| 10 米快速分类 | 10 m Classification | B2, B3, B4, B8 |
| 常规土地覆盖分类 | Land Cover Classification | B2, B3, B4, B8, B11, B12 |
| 生态类型分类推荐 | Ecological Classification | B2, B3, B4, B5, B6, B7, B8, B8A, B11, B12 |
| 植被分析 | Vegetation Analysis | B3, B4, B5, B6, B7, B8, B8A |
| 红边植被增强 | Red Edge Vegetation | B4, B5, B6, B7, B8A |
| 水体提取 | Water Detection | B2, B3, B4, B8, B11 |
| 湿地与水分分析 | Wetland & Moisture | B3, B4, B8, B8A, B11, B12 |
| 火烧迹地 | Burned Area | B4, B8, B11, B12 |
| 城市与建设用地 | Urban & Built-up | B2, B3, B4, B8, B11, B12 |
| 裸地、土壤与荒漠 | Bare Soil & Desert | B2, B3, B4, B8, B11, B12 |
| 雪冰识别 | Snow & Ice | B3, B8, B11 |
| 云与质量控制 | Cloud & Quality Mask | B1, B2, B9, B10, SCL |
| 全部光谱波段 | All Spectral Bands | B1–B12 + B8A |
| 机器学习完整输入 | Machine Learning Full Input | B2, B3, B4, B5, B6, B7, B8, B8A, B11, B12 |
数据组织方案
本文使用 Sentinel-2 Level-2A 地表反射率数据作为主要遥感数据源。为减少云、云影、薄云和异常观测对分类结果的影响,同时保留不同生态类型的主要物候差异,将全年 Sentinel-2 数据划分为春季、夏季和秋季三个时间窗口:
| 季节 | 时间范围 | 生态意义 |
|---|---|---|
| 春季 | 3 月—5 月 | 植被返青、萌发、生长初期 |
| 夏季 | 6 月—8 月 | 植被旺盛生长期,生物量和叶面积较高 |
| 秋季 | 9 月—11 月 | 植被衰退、变色、收割或枯黄阶段 |
对每个季节内所有可用 Sentinel-2 影像,首先进行云、云影、雪和无效像元掩膜,然后对每个像元、每个波段沿时间维度计算中值,生成季节代表影像:
- spring median composite
- summer median composite
- autumn median composite
中值合成可以降低残余云、云影、异常反射和短期地表扰动的影响,相比单日期影像更加稳定;相比全年平均值,又能够保留不同季节之间的光谱差异。
Sentinel-2 如何使用
Sentinel-2 是模型最核心的动态预测特征。训练阶段,在高置信度样本点位置提取春、夏、秋三季的波段反射率和光谱指数,形成样本级特征表;推理阶段,在目标年份 30m 网格上构建同样字段的像元级特征表,再输入 LightGBM/XGBoost 模型。
理论上,Sentinel-2 使用时应遵守四个原则:
- 使用 Level-2A 地表反射率产品,而不是未经大气校正的原始辐射亮度。
- 使用多时相合成,而不是单景影像,以降低云、异常观测和短期扰动影响。
- 训练和推理阶段的波段、指数、季节定义和字段顺序必须一致。
- 所有季节影像必须在同一坐标系、同一分辨率、同一范围和同一像元网格上。
Sentinel-2 不作为标签来源。它只描述目标年份地表光谱状态,模型通过这些光谱状态推断生态类型。
Sentinel-2 如何下载
Sentinel-2 数据理论上应从 Copernicus Data Space Ecosystem、Google Earth Engine、AWS Open Data、Microsoft Planetary Computer 或其他镜像数据平台获取。下载时应选择 Sentinel-2 MSI Level-2A 产品,并按研究区、年份、季节窗口、云量阈值和 MGRS tile 范围筛选影像。
大范围生态分类不建议逐景手工下载,而应采用按区域和时间窗口自动检索的方式。下载或在线处理时,需要记录数据源平台、产品级别、时间范围、云掩膜规则、合成方法和输出网格参数,以保证训练和推理结果可复现。
Sentinel-2 模型输入组织
每个季节输出一个多波段 GeoTIFF,波段顺序固定为:
B02
B03
B04
B05
B06
B07
B08
B8A
B11
B12
NDVI
EVI
NDWI
MNDWI
NBR
NDMI
RENDVI
SCL
共 18 个 band。
其中前 10 个是 Sentinel-2 反射率波段:
| 波段 | 常用含义 | 原始分辨率 |
|---|---|---|
B02 | Blue | 10m |
B03 | Green | 10m |
B04 | Red | 10m |
B05 | Red Edge 1 | 20m |
B06 | Red Edge 2 | 20m |
B07 | Red Edge 3 | 20m |
B08 | NIR | 10m |
B8A | Narrow NIR | 20m |
B11 | SWIR 1 | 20m |
B12 | SWIR 2 | 20m |
后 7 个是基于反射率波段计算的指数:
| 指数 | 公式 |
|---|---|
NDVI | (B08 - B04) / (B08 + B04) |
EVI | 2.5 * (B08 - B04) / (B08 + 6*B04 - 7.5*B02 + 1) |
NDWI | (B03 - B08) / (B03 + B08) |
MNDWI | (B03 - B11) / (B03 + B11) |
NBR | (B08 - B12) / (B08 + B12) |
NDMI | (B08 - B11) / (B08 + B11) |
RENDVI | (B8A - B05) / (B8A + B05) |
最后一个是质量分类层:
SCL
HWSD数据v2.0
世界土壤数据库2.0版(HWSD v2.0)由联合国粮农组织(FAO)和国际应用系统分析研究所(IIASA)联合开发,专为生物物理模型和农业生态评估设计。该版本在保持1公里分辨率的基础上进行了全面升级:数据源替换为WISE30sec数据库,使土壤剖面数量翻倍至21,000个,并将土壤制图单元扩充至近3万个(新增阿富汗、加纳和土耳其等国数据);土层划分由原来的2层细化为7层(0–200厘米),同时新增了有效阳离子交换量、全氮、碳氮比、铝饱和度等属性,并更新了可扎根深度、有效持水量及USDA质地分类等参数;此外,该版本采用了最新的《世界土壤资源参比基础》(WRB)分类标准,引入了最新土地覆盖图层以识别城市人为土和技术土,并升级了数据查看器,从而为全球土壤研究提供了更精细、更全面的数据支持。
原始说明见:HWSDV2.0说明文档
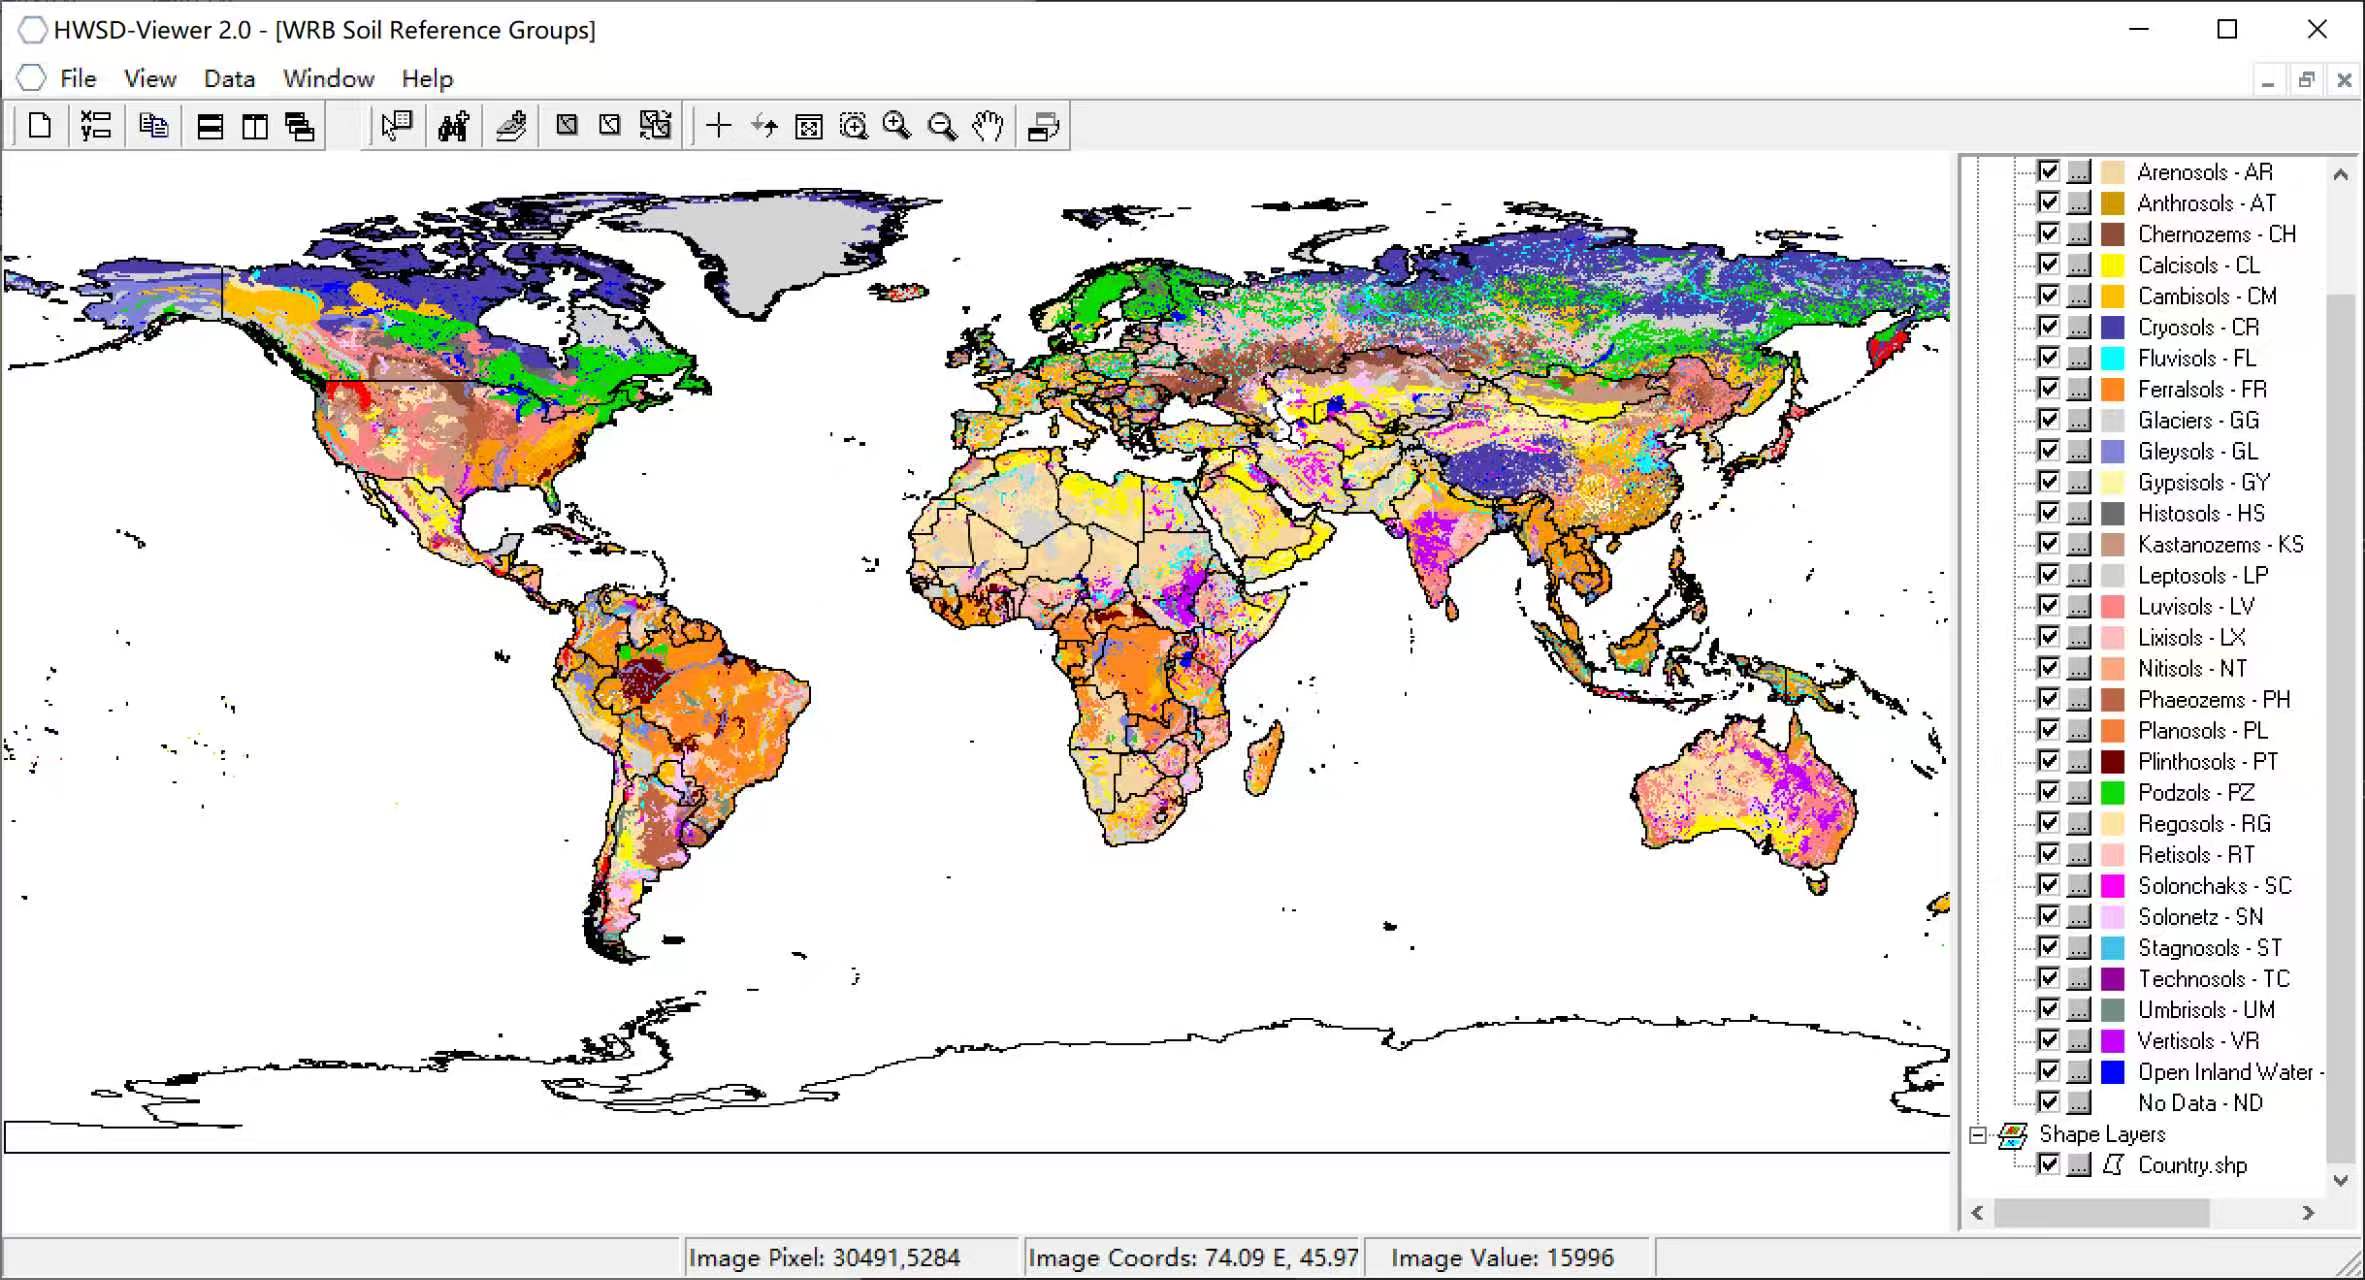
HWSD v2组成
-
HWSD v2 包含两个核心部分
分别是栅格文件,其中保存了每个单元的SMU_ID;另外一个是属性数据库,使用MDB格式存储。
| 数据部分 | 内容 | 格式 |
|---|---|---|
| GIS Raster File(栅格文件) | 每个像元保存一个 Soil Mapping Unit ID(SMU) | TIFF |
| Attribute Database(属性数据库) | 含 SMU 对应的土壤组成、剖面属性(7 层)、CEC/有机碳等 | MDB 数据库 |
- 空间数据与属性表如何关联?
- 主表(General Soil Unit 信息):
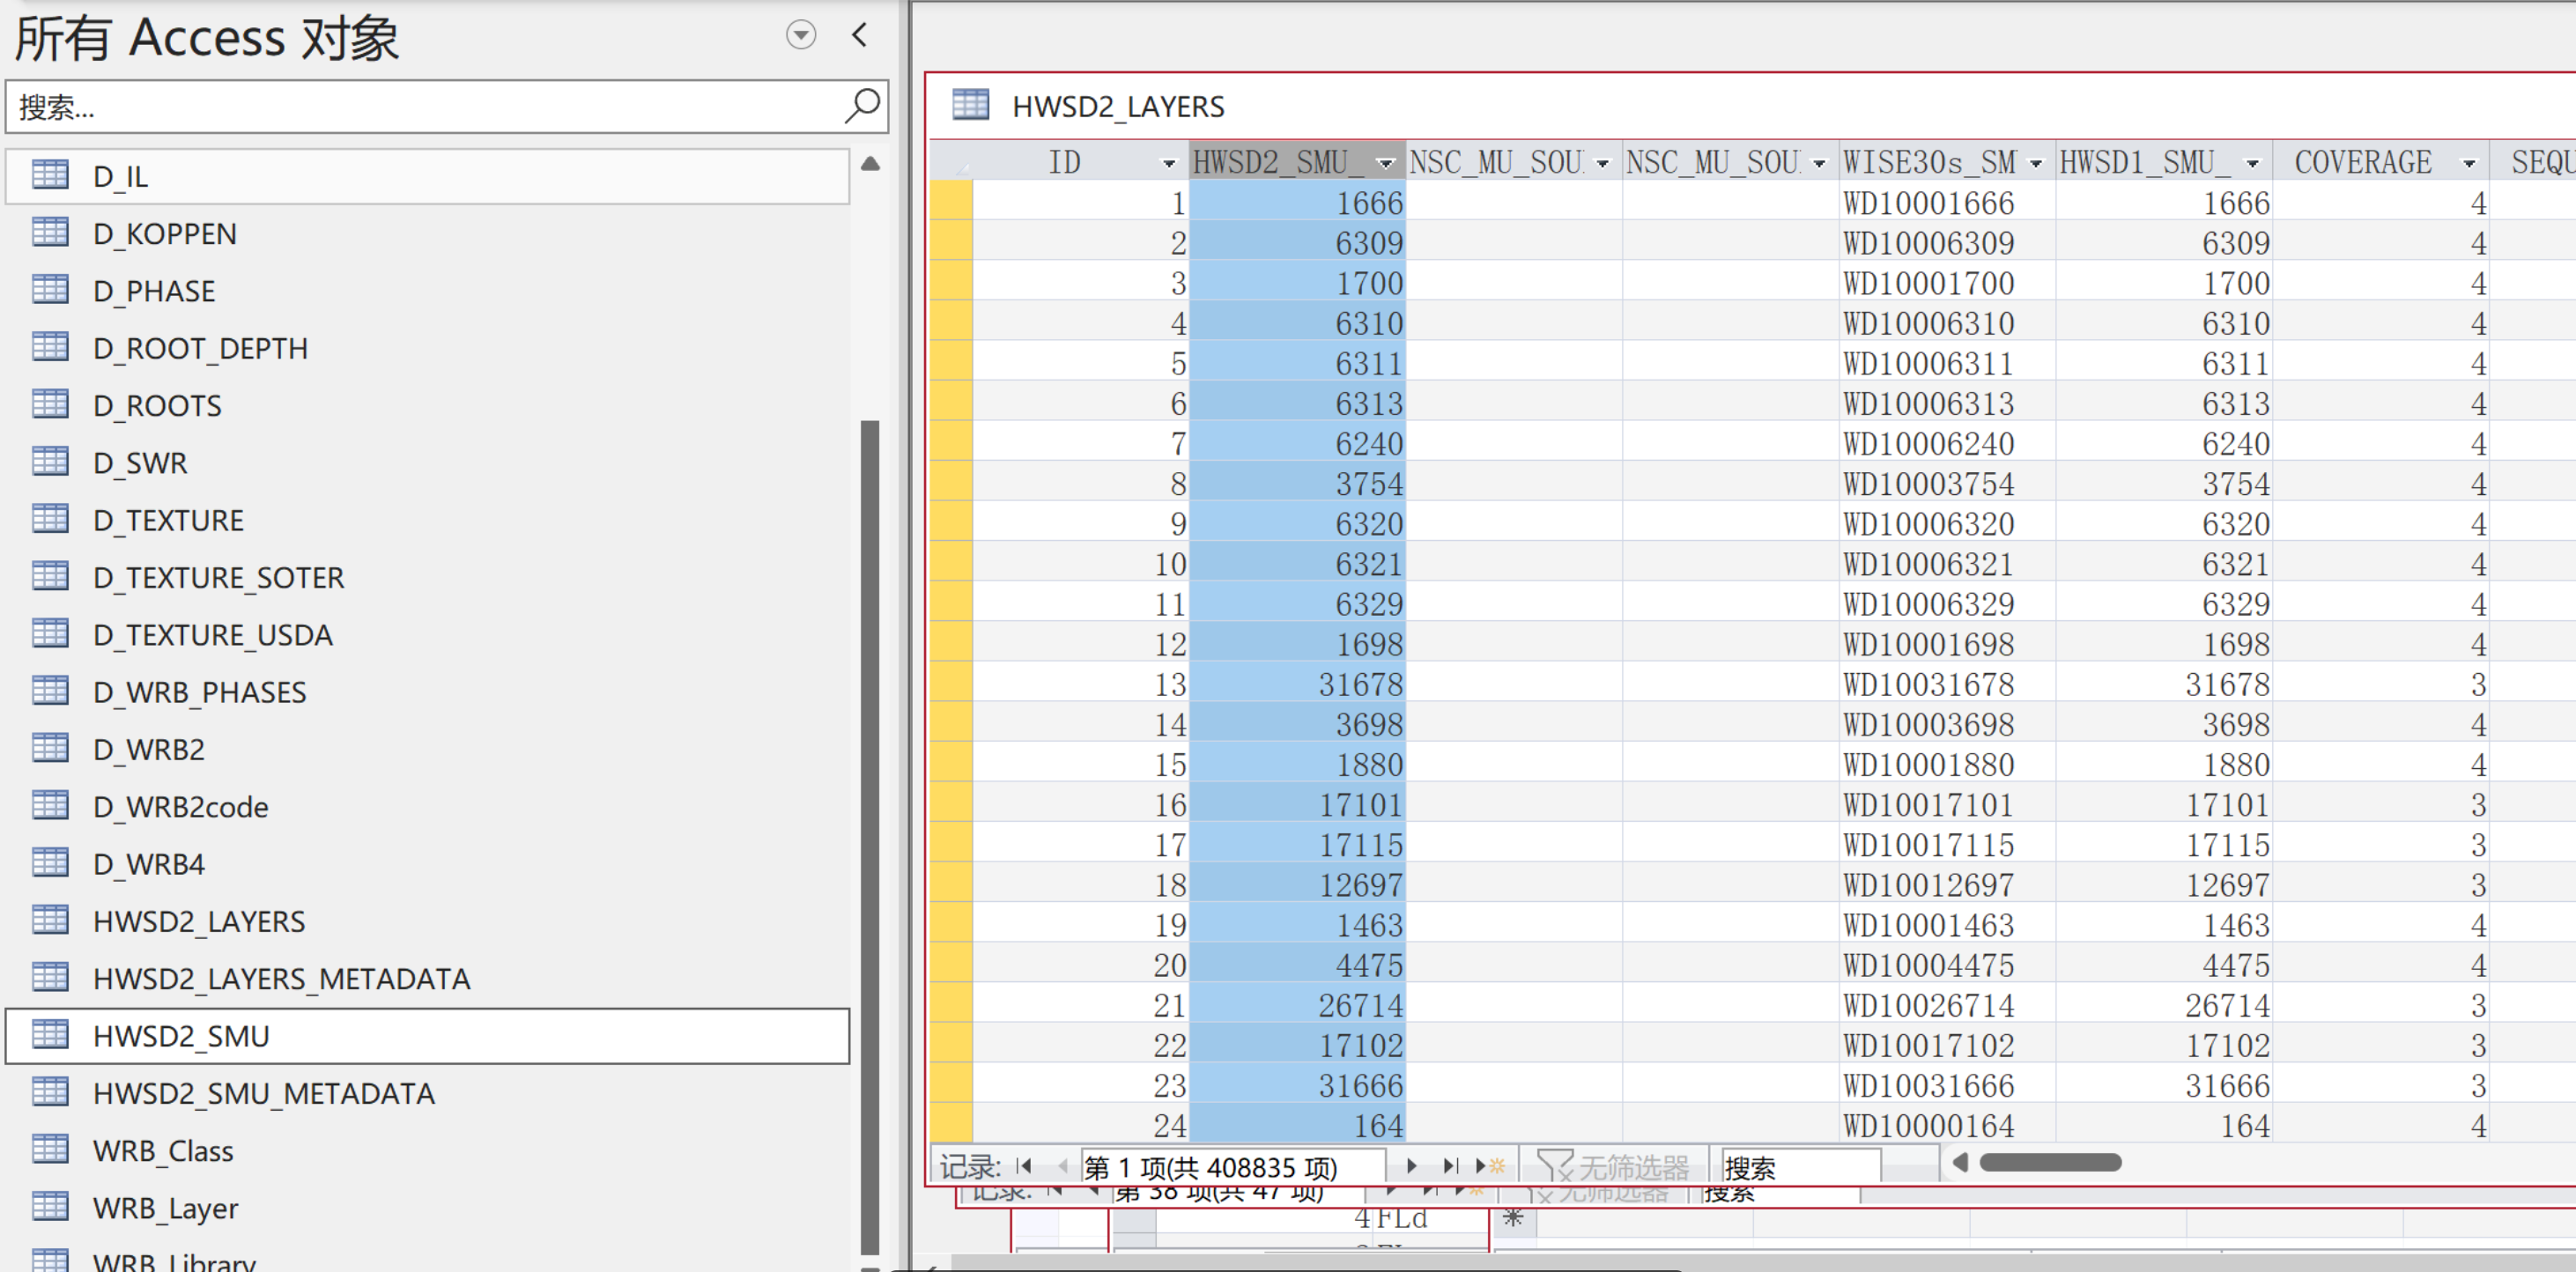
HWSD2_SMU包含:HWSD2_SMU_ID(SMU编号)、SEQUENCE、SHARE、WRB_PHASES / WRB2 / WRB4 / FAO90、ROOT_DEPTH、DRAINAGE、PHASE1/PHASE2、ROOTS、IL、SWR、AWC、ADD_PROP、以及DATABASE_ID(关联到逐层表的键)等。 - 逐层表(Layer attributes, D1–D7):
HWSD2_LAYERS通过DATABASE_ID+LAYER(D1…D7)取TOPDEP/BOTDEP、SAND/SILT/CLAY、BULK/REF_BULK、OC、pH、N、CECsoil、CECclay、ECEC、TEB、BS、AL_SAT、ESP、CaCO3、GYPSUM、EC等。 - 域表(把代码翻译成文字):
D_COVERAGE, D_DRAINAGE, D_PHASE, D_ROOT_DEPTH, D_ROOTS, D_IL, D_SWR, D_TEXTURE_USDA, D_WRB4, D_WRB2, D_WRB2code, D_WRB_PHASES, …用来把HWSD2_SMU中的数值/代码转成可读名称。 - 元数据:
HWSD2_SMU_METADATA,HWSD2_LAYERS_METADATA(字段说明) - WRB 辅助:
WRB_Class,WRB_Layer,WRB_Library(更细的 WRB 对照/层级库,可选)
1、数据如何用于全球土壤计算?
| 计算内容 | 依赖什么字段? |
|---|---|
| AWC(可利用水容量) | Sand/Silt/Clay、Bulk Density、Root Depth、Coarse fragments、Salinity |
| Root depth soil water storage | LAYER 表 + ROOTABLE DEPTH |
| 土壤类型统计(WRB/FAO 占比) | SHARE + SMU 栅格 |
| 土壤碳储量估算 | Organic C × Bulk Density × Layer Depth |
| CEC / 盐碱化分析 | CECsoil、ESP、EC、Al-saturation |
2、栅格分辨率与全球范围
| 信息 | 内容 |
|---|---|
| 分辨率 | 30 arc-second(约 1km) |
| 数据量 | 29,385 个 SMU(全球) |
| 每个 SMU 最多包含 | 12 个土壤单元(SEQ=1~12) |
| 数据来源 | DSMW、ESDB、China Soil Map、WISE30sec |
HWSD v2.0 MDB 数据库介绍
HWSD v2.0 MDB 数据库的三大部分
- Soil mapping unit identifiers(土壤图单元标识),字段为SMU_ID,定义“栅格编号是什么”
- 包含字段:
Coverage、SMU(Soil Mapping Unit ID)、Dominant soil unit (WRB 2022)、Dominant soil unit (FAO90)等。
- 包含字段:
- General soil unit information(土壤单元基本信息),定义“编号对应哪些土壤单元及基本信息”。
- 每个图单元(SMU_ID)下最多 12 个子单元(dominant + associated soils)。
- 字段包括:
SEQ(序号)、SHARE(比例%)、DATABASE ID、NATIONAL SOIL CLASSIFICATION(国家分类名)、SOIL UNIT SYMBOL / NAME(WRB/FAO90)、ROOTABLE SOIL DEPTH、PHASE1/PHASE2、Drainage class、AWC for rootable soil depth等。
- Soil Attributes per depth layer(按深度层的属性),定义“每个土壤单元在不同深度层的理化属性”。
- 每个土壤单元有 7 个深度层(D1–D7)。
- 每层包含以下字段:
DEPTH_TOP,DEPTH_BOTTOMCOARSE_FRAGMENTS,SAND,SILT,CLAY,TEXTURE_CLASSBULK_DENSITY,REFERENCE_BD,ORGANIC_CARBON,pH_H2OTOTAL_N,C/N,CECsoil,CECclay,ECEC,TEB,BS,Al_sat,ESPCaCO3,Gypsum,Electric_conductivity
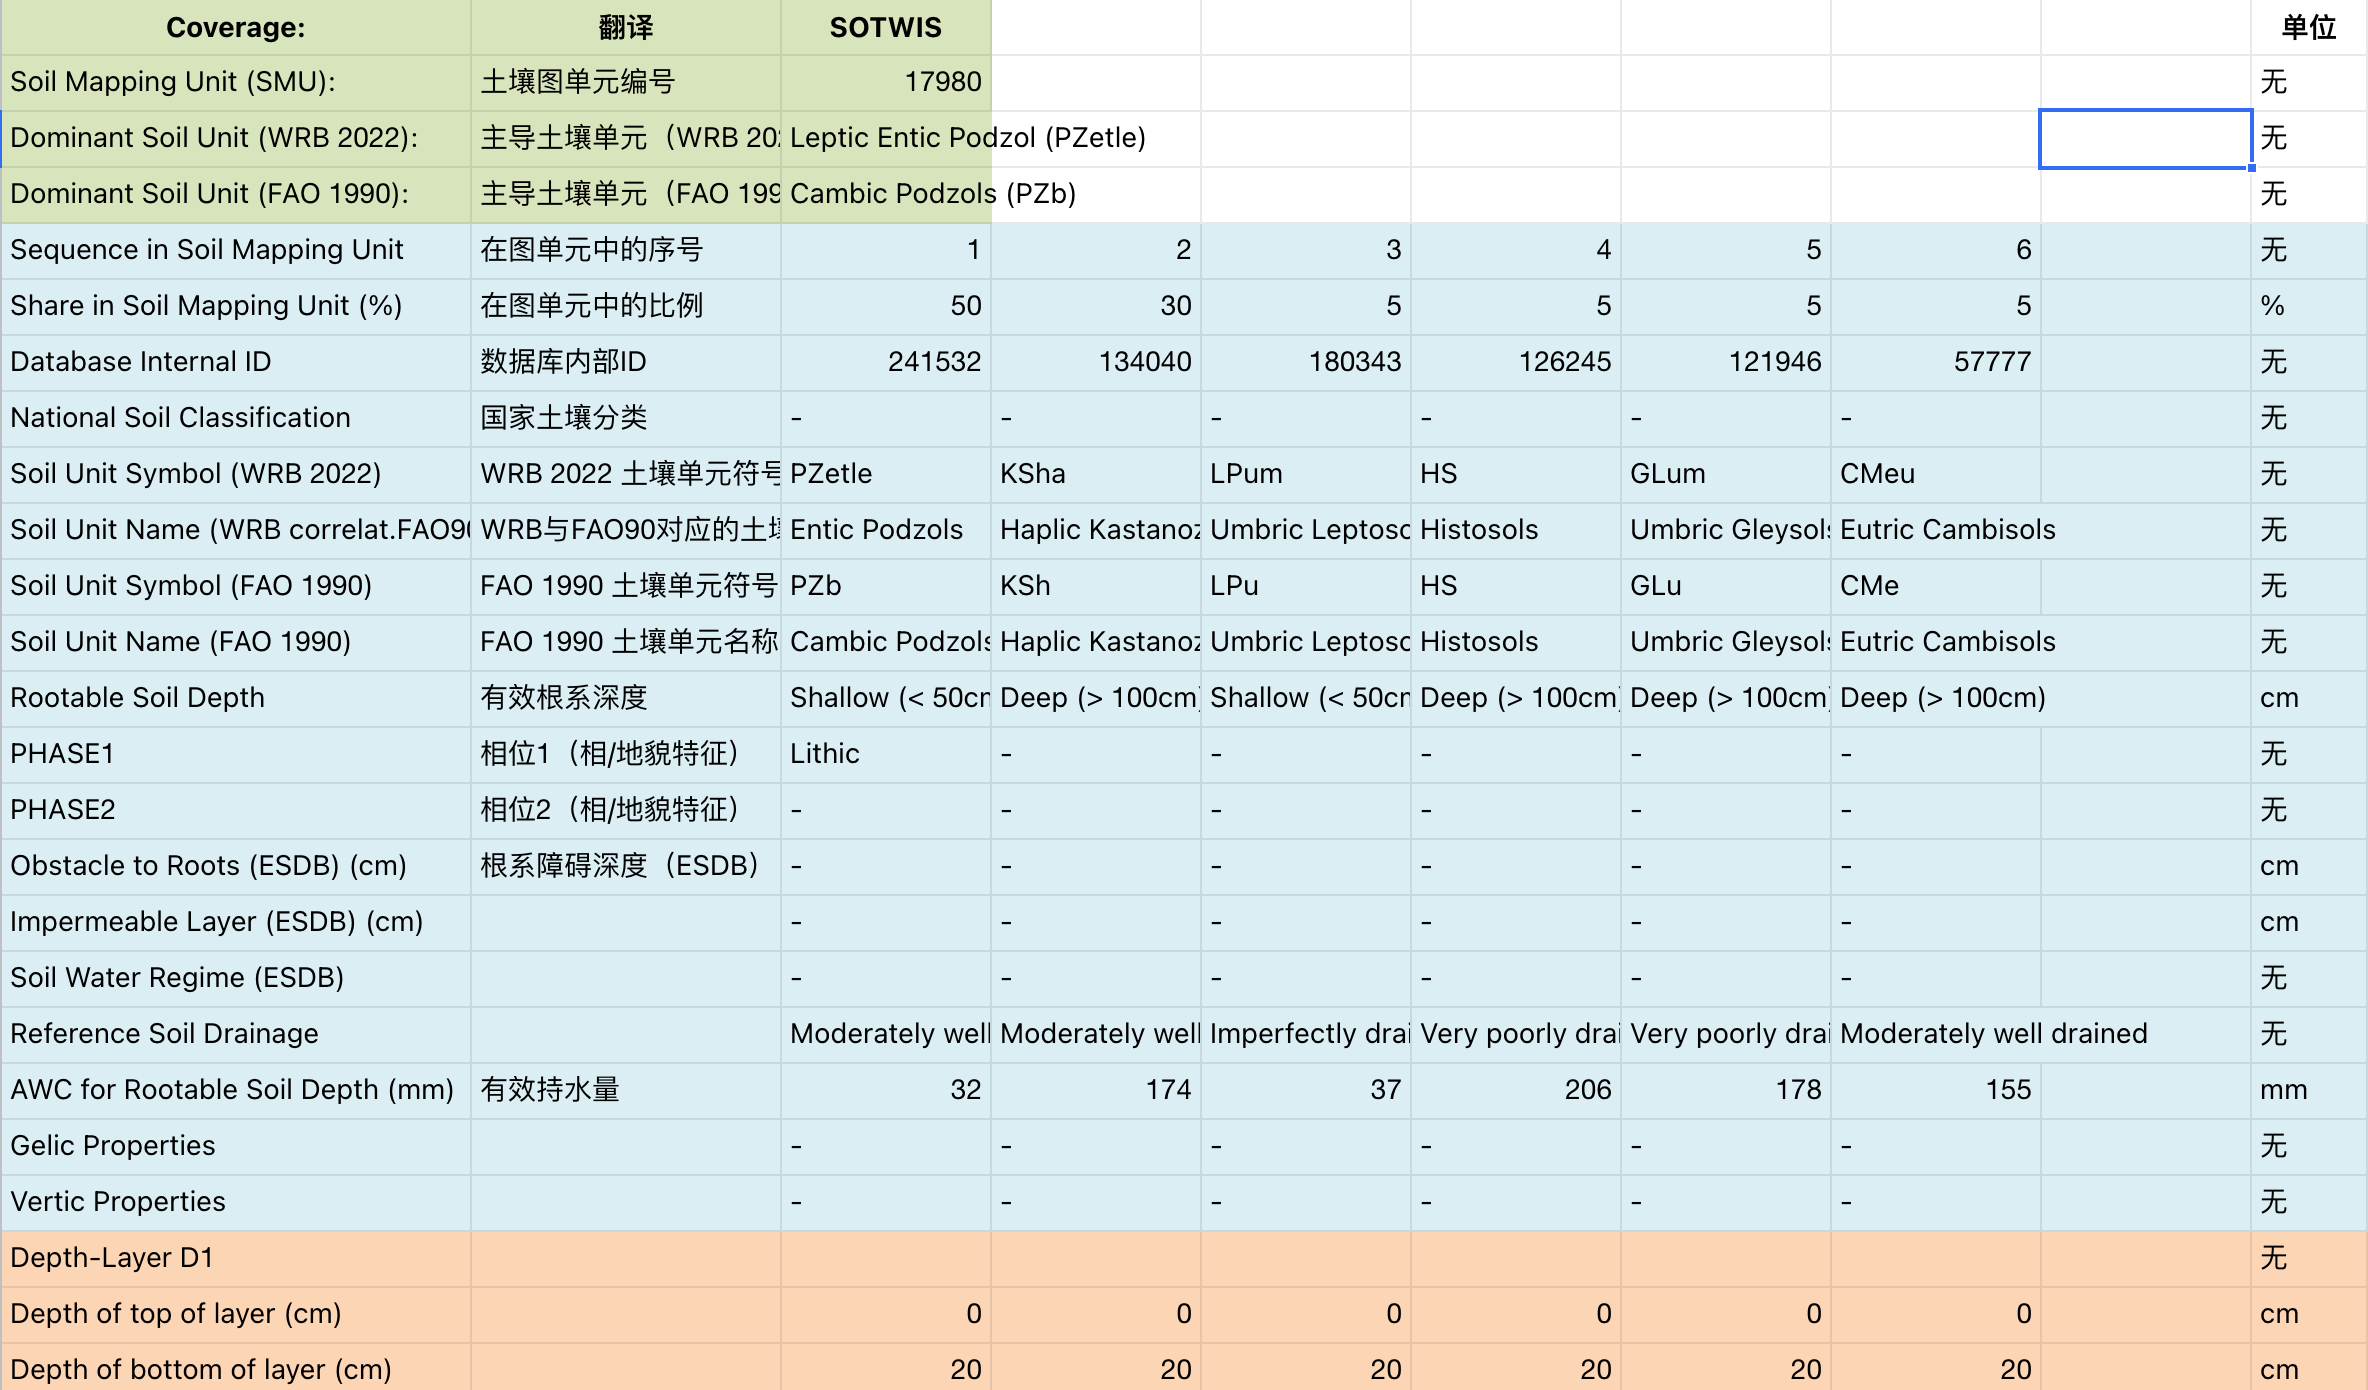
土壤单元表介绍
土壤地图单元 Soil mapping unit identifiers
| 字段名 | 中文名称 | 英文说明 | 备注 / 来源 |
|---|---|---|---|
| COVERAGE | 数据来源 | Data source of SMU (e.g., ESDB, DSMW, China) | 见表 D_COVERAGE |
| SMU / HWSD2_SMU_ID | 土壤图单元编号 | Soil Mapping Unit (unique code in raster/grid) | 栅格值用于属性连接 |
| DOM_SOIL_WRB2022 | 主导土壤单元(WRB 2022) | Dominant Soil Unit under WRB 2022 | 见 附录1 / 域表 D_WRB4 |
| DOM_SOIL_FAO90 | 主导土壤单元(FAO90) | Dominant Soil Unit under FAO 1990 | 见 附录1 / 域表 D_FAO90 |
土壤单元基本信息 general soil unit information
第 2.3.2 节(General soil unit information) 是讲结构: 它说明每一个土壤图单元(SMU)里,主要土壤类型(Soil Units)以及占多少比例(Share),以及每个土壤单元的宏观特征(质地、相、排水、可生根深度、AWC 等)。
这些字段覆盖了 HWSD v2 主体表(相当于旧版 HWSD_DATA)中所有非分层属性。
- HWSD2_SMU,数据信息
- HWSD2 SMU_METADATA,HWSD2SMU字段的信息描述
| FIELD | UNIT | DESCRIPTION | DATATYPE | 中文描述 | DOMAIN | 备注 |
|---|---|---|---|---|---|---|
| ID | — | Database internal ID | Number | 数据库内部记录编号 | — | |
| HWSD2_SMU_ID | — | Soil Mapping Unit (HWSD-2) | Number | HWSD v2 土壤图单元编号 | — | |
| WISE30s_SMU_ID | — | Soil Mapping Unit (WISE30s) | String | WISE30s 土壤图单元编号 | — | |
| HWSD1_SMU_ID | — | Soil Mapping Unit (HWSD-1) | Number | HWSD v1 土壤图单元编号 | — | |
| COVERAGE | — | Source coverage (ESDB, DSMW, China, etc.) | Number | 数据来源 | D_COVERAGE | (欧洲、中国等) |
| SHARE | % | Share of soil unit within mapping unit | Number | 土壤单元比例 | — | 占比最大的土壤单元在图单元中的面积比例 |
| WRB4 | Class | Soil Unit Symbol (WRB 2022) | String | WRB 2022 土壤单元 | D_WRB4 | |
| WRB_PHASES | Class | Soil Unit Symbol (WRB 2022 + phases) | String | WRB 2022 土壤单元含相 | D_WRB_PHASES | |
| WRB2 | Class | Dominant Soil Group (WRB3) | String | WRB3 土壤单元 | D_WRB2 | |
| WRB2_CODE | Class | Dominant Soil Group (WRB + PHASES) | String | WRB + 相土壤单元 | D_WRB2code | |
| FAO90 | Class | Dominant Soil Group (FAO 90) | String | FAO90 分类 | D_FAO90 | |
| KOPPEN | Class | Köppen-Geiger Climate Class | String | Köppen-Geiger 气候分类 | D_KOPPEN | |
| TEXTURE_USDA | Class | Topsoil Texture (USDA triangle) | Number | 表层土壤质地类型 | D_TEXTURE_USDA | |
| REF_BULK_DENSITY | g/cm³ | Reference Bulk Density | Number | 参考容重 | — | |
| BULK_DENSITY | g/cm³ | Bulk Density | Number | 实测容重 | — | |
| DRAINAGE | Class | Reference Soil Drainage | Number | 排水等级 | D_DRAINAGE | |
| ROOT_DEPTH | Class | Rooting Depth | Number | 根系可达深度等级 | D_ROOT_DEPTH | |
| AWC | mm/m | Available Water Capacity | Number | 可利用水容量 | — | |
| PHASE1 | Class | Soil phase 1 (e.g., stony, lithic, saline) | Number | 土壤相 1 | D_PHASE | 如砾质、岩性、盐渍等) |
| PHASE2 | Class | Soil phase 2 | Number | 土壤相 2 | D_PHASE | |
| ROOTS | Class | Obstacles to Roots (ESDB) | Number | 根系障碍等级(ESDB) | D_ROOTS | |
| IL | Class | Impermeable Layer (ESDB) | Number | 不透水层等级(ESDB) | D_IL | |
| ADD_PROP | Class | Additional Soil Properties (e.g., Gelic, Vertic) | Number | 附加特性 | D_ADD_PROP | (如冻土性、膨胀性等) |

土壤分层属性表
每层属性Soil Attributes per depth layer
D1-D7层每层土壤的属性,包括化学和物理属性。
通过**HWSD2_SMU_ID **查询每个单元的属性信息,包含所有土壤单元的信息,以及多层的属性信息。

表头 HWSD2_LAYERS_METADATA
| ID | FIELD | UNIT | DESCRIPTION | 中文说明 |
|---|---|---|---|---|
| 1 | ID | — | Database Internal ID | 数据库内部编号 |
| 2 | HWSD2_SMU_ID | — | Soil Mapping Unit HWSD2 | 土壤图单元编号(HWSD2) |
| 3 | WISE30s_SMU_ID | — | Soil Mapping Unit WISE30s | WISE30s 土壤图单元编号 |
| 4 | HWSD1_SMU_ID | — | Soil Mapping Unit HWSD1 | HWSD1 土壤图单元编号 |
| 5 | COVERAGE | — | Coverage | 数据来源区域(如ESDB、中国、DSMW等) |
| 6 | SEQUENCE | — | Sequence in Soil Mapping Unit | 在图单元中的序号(1为主导土壤) |
| 7 | SHARE | % | Share in Soil Mapping Unit | 土壤单元占该图单元比例(%) |
| 8 | NSC_MU_SOURCE1 | — | National Soil Classification | 国家土壤分类(名称) |
| 9 | NSC_MU_SOURCE2 | — | National Soil Classification | 国家土壤分类(代码) |
| 10 | WRB_PHASES | Class | Soil Unit Symbol (WRB 2022) | WRB2022 土壤单元符号(含相) |
| 11 | WRB4 | Class | Soil Unit Symbol (WRB 2022 - 4 digit) | WRB2022 土壤符号(精细编码) |
| 12 | WRB2 | Class | Soil Unit Symbol (WRB 2022 - 2 digit) | WRB2022 土壤符号(二位代码) |
| 13 | FAO90 | Class | Soil Unit Symbol (FAO 1990) | FAO90 土壤单元代码 |
| 14 | ROOT_DEPTH | Class | Rootable Soil Depth | 可生根土层深度等级 |
| 15 | PHASE1 | — | Soil Phase 1 | 土壤相1(如石质、盐渍等) |
| 16 | PHASE2 | — | Soil Phase 2 | 土壤相2 |
| 17 | ROOTS | cm | Obstacle to Roots (ESDB) | 根系障碍等级(或深度) |
| 18 | IL | cm | Impermeable Layer (ESDB) | 不透水层出现深度/等级 |
| 19 | SWR | Class | Soil Water Regime (ESDB) | 土壤水分状态(湿润程度) |
| 20 | DRAINAGE | Class | Reference Soil Drainage | 排水状况等级 |
| 21 | AWC | mm | AWC for Rootable Soil Depth | 可生根层可利用水容量 |
| 22 | ADD_PROP | Class | Additional Properties | 其他属性(如冻土性、膨胀性) |
| 23 | LAYER | — | Depth Layer (D1–D7) | 土层编号(D1–D7) |
| 24 | TOPDEP | cm | Depth of top of layer | 该层顶部深度 |
| 25 | BOTDEP | cm | Depth of bottom of layer | 该层底部深度 |
| 26 | COARSE | % vol | Coarse fragments | 粗颗粒体积分数 (>2mm) |
| 27 | SAND | % weight | Sand | 砂含量(质量百分比) |
| 28 | SILT | % weight | Silt | 粉砂含量 |
| 29 | CLAY | % weight | Clay | 黏粒含量 |
| 30 | TEXTURE_USDA | — | Texture class (USDA) | USDA土壤质地类别 |
| 31 | TEXTURE_SOTER | — | Texture class (SOTER) | SOTER 土壤质地分类 |
| 32 | BULK | g/cm³ | Bulk Density | 容重(实测) |
| 33 | REF_BULK | g/cm³ | Reference Bulk Density | 参考容重 |
| 34 | ORG_CARBON | % weight | Organic Carbon Content | 有机碳含量 |
| 35 | PH_WATER | pH | pH in water | 水浸pH值 |
| 36 | TOTAL_N | g/kg | Total nitrogen content | 全氮含量 |
| 37 | CN_RATIO | — | Carbon/Nitrogen ratio | 碳氮比 |
| 38 | CEC_SOIL | cmolc/kg | CEC soil | 土壤CEC(有效阳离子交换量) |
| 39 | CEC_CLAY | cmolc/kg | CEC clay | 黏粒CEC(校正有机质) |
| 40 | CEC_EFF | cmolc/kg | ECEC | 有效CEC(交换性阳离子+酸离子) |
| 41 | TEB | cmolc/kg | Total Exchangeable Bases | 总交换性碱阳离子 |
| 42 | BSAT | % CEC | Base Saturation | 碱饱和度 |
| 43 | ALUM_SAT | % ECEC | Aluminium saturation | 铝饱和度 |
| 44 | ESP | % | Exchangeable Sodium Percentage | 交换性钠百分比(盐碱化指标) |
| 45 | TCARBON_EQ | % weight | Calcium Carbonate | 碳酸钙含量 |
| 46 | GYPSUM | % weight | Gypsum content | 石膏含量 |
| 47 | ELEC_COND | dS/m | Electric Conductivity | 电导率(盐分) |
HWSD 如何使用
HWSD 在模型中作为土壤环境辅助特征使用,不作为生态分类标签。其栅格文件表达的是 Soil Mapping Unit ID,而不是直接表达砂粒、黏粒、pH、有机碳等属性。因此,理论使用流程应是:先读取目标位置或目标网格上的 SMU_ID,再通过属性表把 SMU_ID 转换为土壤类型、质地、排水、有效水容量和逐层理化属性。
HWSD 的空间分辨率约为 30 arc-second,远低于 30m Sentinel-2 预测网格。将 HWSD 与 30m 模型结合时,应把它理解为区域尺度土壤背景变量,而不是 30m 精度土壤图。SMU_ID 属于分类编码,重采样到目标网格时理论上只能使用最近邻,不能使用双线性、三次卷积或平均值重采样。
对同一个 SMU 包含多个土壤单元的情况,可优先使用主导土壤单元,也可按土壤单元面积比例对连续属性加权汇总。对逐层属性,可根据生态分类需求提取表层、0-60cm 或 0-100cm 的厚度加权特征。
HWSD 如何下载
HWSD v2.0 理论上应从 FAO、IIASA 或其官方发布页面获取。下载时需要同时获取空间栅格文件和属性数据库,因为二者必须通过 SMU_ID 关联后才有完整意义。
HWSD 建模字段
第一版使用这些字段:
- 分类/编码特征:
WRB2、WRB4、FAO90、TEXTURE_USDA、DRAINAGE、ROOT_DEPTH、PHASE1、PHASE2。 - 连续特征:
AWC、SAND、SILT、CLAY、BULK、REF_BULK、ORG_CARBON、PH_WATER、TOTAL_N、CEC_SOIL、CEC_CLAY、CEC_EFF、BSAT、ESP、ELEC_COND。
对 HWSD2_SMU 中一个 SMU 有多个土壤单元的情况,第一版:
- 样本级特征:优先取
SEQUENCE=1或SHARE最大的主导土壤单元。 - 更精细版本:对同一
HWSD2_SMU_ID下多个SEQUENCE按SHARE加权汇总连续字段。 - 分类字段:可取主导土壤单元,或保留主导类编码和主导类占比。
对 HWSD2_LAYERS 的逐层字段,第一版:
- 优先使用表层
D1(0-20cm)或D1-D3(0-60cm)厚度加权平均。 - 后续可增加
0-100cm、100-200cm等分层统计,但先不要把特征维度做得过大。
HWSD 全国尺度使用原则
全国处理不建议预先生成所有土壤属性的全国 30m 栅格。
推荐策略:
- 训练阶段:对样本点从 HWSD2 栅格读取
HWSD2_SMU_ID,再 join 属性表。 - 预测阶段:按
R1-R9 -> grid分块,临时把HWSD2_SMU_ID最近邻对齐到当前 30m grid,再 join 或映射为模型需要的土壤特征。 - 只长期保存必要的中间结果,例如 R 区或 grid 的
HWSD2_SMU_ID对齐栅格、属性表转换结果、字段编码映射。
全国尺度使用时,应避免把所有土壤属性都预先栅格化为全国 30m 产品。更合理的方式是保留 SMU_ID 空间索引和属性查找表,在训练样本或预测分块需要时再进行关联映射。
理论原则包括:
- 对大区或分块预测,可以保留当前目标网格下的
HWSD2_SMU_ID对齐结果。 - 对大量临时预测网格,可以按需生成临时 SMU_ID 对齐层,用完后只保留必要结果。
- SMU_ID 是分类编码,任何网格变换都应使用最近邻或众数规则,避免产生不存在的 SMU_ID。
- 属性关联不应逐像元逐条查询,而应对唯一 SMU_ID 批量映射,提高稳定性和效率。
- 全国版本可建立统一的
SMU_ID -> 土壤特征查找表,再在各生态分区或预测分块中复用。
DEM 地形数据
数据介绍
DEM 表示地表高程,是生态分类中重要的稳定自然环境变量。由 DEM 可以进一步派生坡度、坡向、坡向正弦值和坡向余弦值等地形因子。地形条件影响水热分布、植被类型、土壤发育、湿地形成和人类利用方式,因此对区分森林、草地、灌丛、农田、裸地、高山植被和湿地等类型具有重要作用。
常见 DEM 数据源包括 ASTER GDEM、SRTM、Copernicus DEM、ALOS AW3D30 等。不同 DEM 在覆盖范围、空间分辨率、垂直精度和空洞处理方法上不同,应根据全国一致性和数据许可选择。本次训练采用的是ASTER GDEM。
2009 年 6 月 30 日,美国航天局(NASA)与日本经济产业省(METI)共 同推出了最新的地球电子地形数据 ASTER GDEM(先进星载热发射和反射辐射 仪全球数字高程模型),该数据是根据 NASA 的新一代对地观测卫星 TERRA 的详尽观测结果制作完成的。这一全新地球数字高程模型包含了先进星载热发射 和反辐射计(ASTER)搜集的 130 万个立体图像。 ASTER 测绘数据覆盖范围为北纬 83°到南纬 83°之间的所有陆地区域,比 以往任何地形图都要广得多,达到了地球陆地表面的 99%。此前,最完整的地 形数据是由 NASA 的航天飞机雷达地形测绘任务(SRTM)提供的,此项任务对 位于北纬 60°和南纬 57°间地球 80%的陆地进行了测绘。
如何使用
DEM 在模型中作为环境特征使用。训练阶段,在样本点位置提取高程、坡度、坡向等变量;推理阶段,将 DEM 及其派生地形因子对齐到目标 30m 网格,并作为每个像元的静态输入特征。
DEM 本身是连续变量,对齐到目标网格时理论上可使用双线性重采样;坡度、坡向等派生变量应在统一投影和合理分辨率下计算,避免经纬度单位直接参与坡度计算。坡向是环状变量,不宜直接作为普通数值使用,通常转换为 aspect_sin 和 aspect_cos 以表达方向连续性。
如何下载
DEM 应从官方或可信开放平台下载。理论获取方式包括 NASA、USGS、Copernicus、JAXA 或相关镜像平台。下载时应关注覆盖范围、空间分辨率、垂直基准、空洞填补方法、数据版本和使用许可。
目前,ASTER GDEM 数据可以在网上免费获取。用户通过日本的 ERSDAC (Earth Remote Sensing Data Analysis Center,地球遥感数据分析中心) 或美国 NASA 的 LP DAAC(Land Processes Distributed Active Archive Center,美国陆地过程分布式活动档案中心)免费下载这些数据。当然, 拥有数据下载权限之前都需要进行相关网站的用户注册和所需数据的申请。

ESA WorldCover 土地利用数据
数据介绍
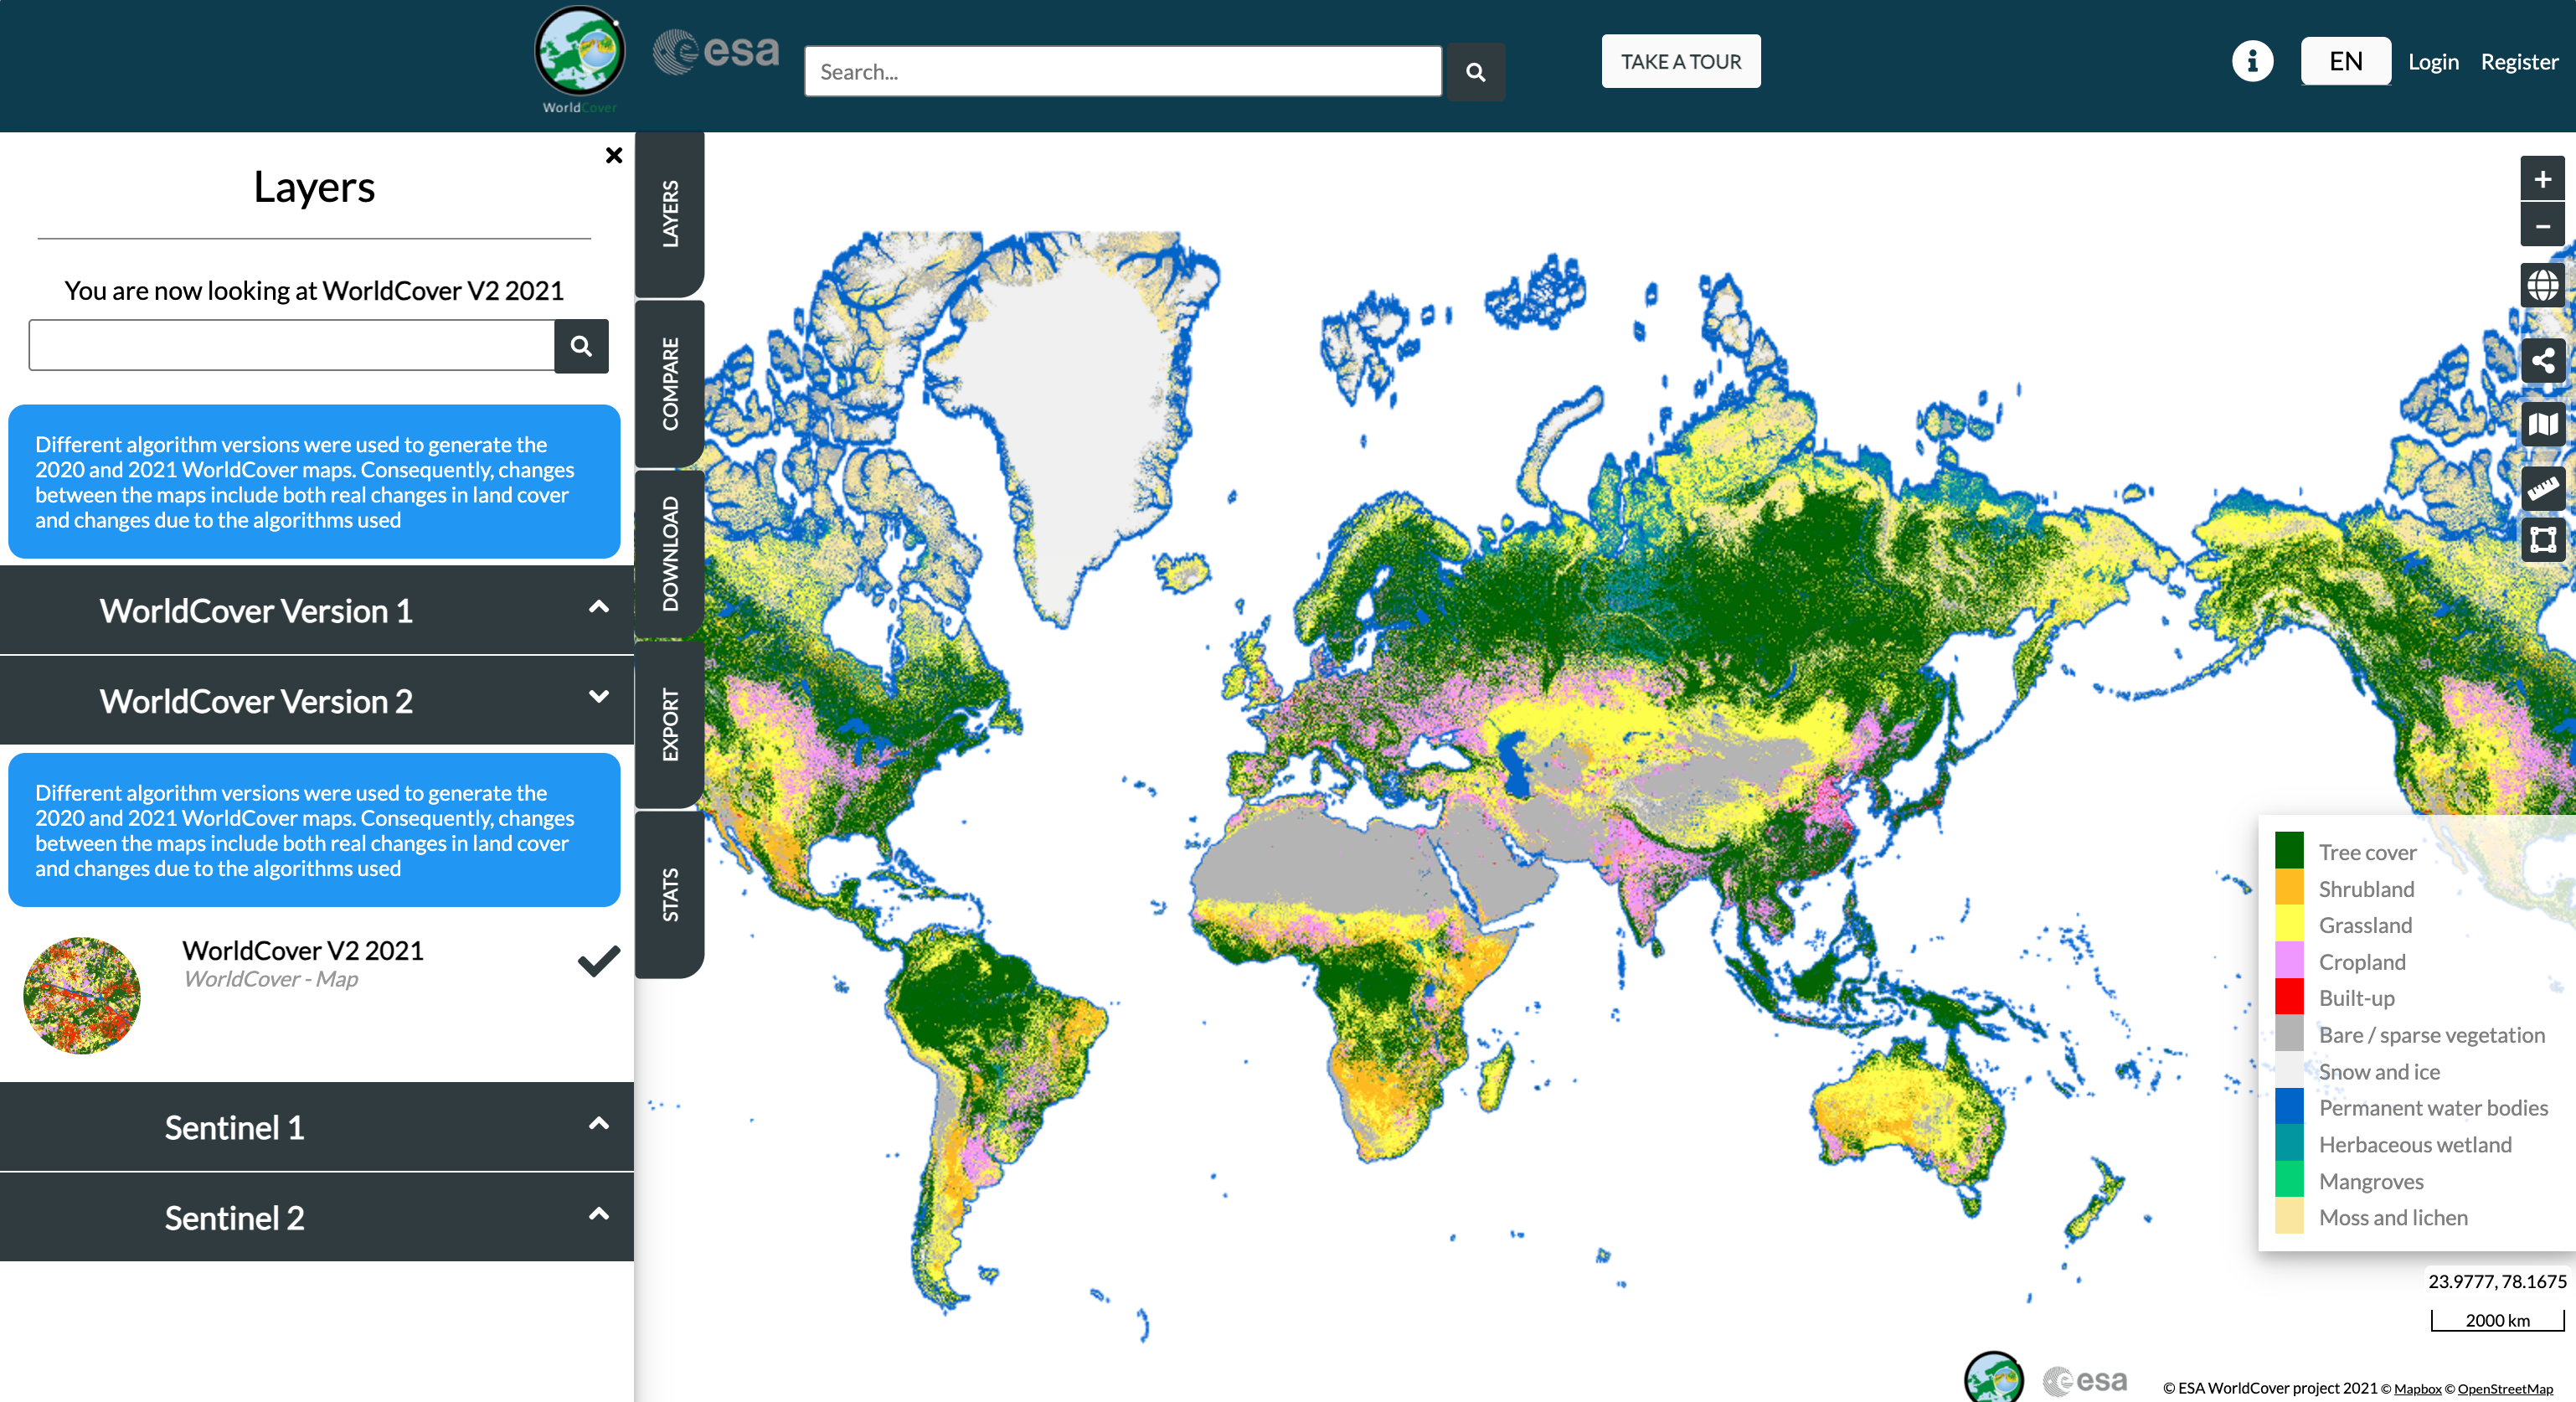
ESA WorldCover是欧洲航天局(ESA)发布的高分辨率全球土地覆盖产品。目前提供了2020年和2021年两个年度的全球覆盖图,每像元10米,采用哨兵-1雷达和哨兵-2光学影像融合制图。分类系统包含11类地物(10大类+红树林),例如林地、灌丛、草地、农作物地、建筑用地、裸地、积雪冰川、水体、湿地、红树林、苔藓地衣等。2020产品的独立验证总体精度约74.4%;2021版精度进一步提升到约76.7%,满足设计要求的75%以上精度水平。
ESA WorldCover 不是本项目的生态分类标签。它的分类体系是土地覆盖体系,与三级生态类型并不完全一致。但它可以作为外部一致性证据,用于样本 QA、辅助特征和模型结果检查。
详细信息可去ESA网站查看。
如何使用
ESA WorldCover 在模型中可承担三类作用:第一,用于高置信度样本阶段的外部一致性记录,帮助识别明显冲突样本;第二,作为预测期可获得的辅助类别特征,提供土地覆盖背景;第三,用于模型输出的 QA,检查生态分类结果是否与外部土地覆盖证据存在明显矛盾。
由于 ESA 是分类栅格,对齐到目标网格时理论上应使用最近邻或众数重采样,不能使用双线性或三次卷积。使用时应注意 ESA 类别与生态分类类别不是一一对应关系,例如 ESA 的 grassland、cropland、tree cover 与生态分类中的草地、农田、森林细分类存在体系差异,不能简单替代生态标签。
如何下载
ESA WorldCover 理论上应从 ESA WorldCover 官方网站、Zenodo 发布页面、Google Earth Engine 或其他官方镜像平台获取。下载时应确认产品年份、版本号、类别编码表、空间分辨率、坐标系统和数据许可。
- 数据可视化与探索
- 用户可通过 WorldCover 在线查看器进行数据的可视化与探索。
- 同时提供 Terrascope WMS 服务图层,支持 WMTS 和 WMS 服务。
- 图层标识说明
- Gamma0 图层:esa-worldcover-s1vvvhratio-10m-2020-v1_vvvhratio, esa-worldcover-s1vvvhratio-10m-2021-v2_vvvhratio
- RGB 图层:esa-worldcover-s2rgbnir-10m-2020-v1_tcc, esa-worldcover-s2rgbnir-10m-2021-v2_tcc
- 假彩色图层:esa-worldcover-s2rgbnir-10m-2020-v1_fcc, esa-worldcover-s2rgbnir-10m-2021-v2_fcc
- NDVI 图层:esa-worldcover-ndvi-10m-2020-v1_ndvi, esa-worldcover-ndvi-10m-2021-v2_ndvi
- SWIR 图层:esa-worldcover-swir-10m-2020-v1_swir, esa-worldcover-swir-10m-2021-v2_swir
- 数据获取与访问
- 该数据集在 Terrascope 和 AWS 开放数据注册表上对所有用户免费开放。
- Sentinel-1 和 Sentinel-2 合成数据分别存储在 AWS 公共存储桶中(eu-central-1 区域):
s3://esa-worldcover-s1和s3://esa-worldcover-s2。 - 官方提供了产品网格的 FlatGeobuf 文件,支持在 QGIS 或 Python 中远程打开,可用于检索所需瓦片的 S3 路径或 URL 链接。
- 数据格式与技术规格
- 格式与投影:以云优化 GeoTIFF (COGs) 格式提供,采用 WSG84 投影,按 1°×1° 的网格进行分幅。
- 空间分辨率:大部分产品分辨率约为 10米,但 SWIR 合成产品分辨率为 20米(具体以度为单位的实际分辨率请参阅元数据表)。
- 数据来源:Sentinel-2 合成数据基于 L2A 档案生成;GAMMA0 合成数据则是使用 GAMMA 软件对 Sentinel-1 GRD 产品进行预处理后生成的。
JRC Global Surface Water 水体数据
数据介绍
JRC Global Surface Water 是欧盟联合研究中心基于长期 Landsat 观测生成的全球地表水数据集。它提供水体出现频率、季节性、变化、水体范围和历史最大水体范围等信息,可用于描述长期稳定水体、季节性水体、间歇性积水和水体变化背景。
生态分类中,水体、湿地、坑塘、水库、河流、消落带和岸线过渡区往往仅靠单期 Sentinel-2 光谱难以稳定区分。JRC 提供的是长期水文证据,适合补充单年光谱分类的不足。
当前数据准备采用的是 JRC Global Surface Water v1.5 的 2024 发布版。该版本以 10 度经纬网瓦片组织,文件名中包含产品名、经纬度瓦片位置、版本号和发布年份。例如,110E_30N 表示经度 110E 附近、纬度北缘为 30N 的 10 度瓦片,覆盖纬度范围约为 20N-30N。下载器按研究区经纬度范围或生态分区范围计算相交瓦片,再按产品类型获取对应 GeoTIFF。
JRC GSW v1.5 2024 可下载的主要产品包括:
| 产品 | 含义 | 本模型使用状态 |
|---|---|---|
occurrence | 长期观测中水体出现频率,通常为 0-100 百分值 | 核心使用 |
recurrence | 水体重复出现程度,反映水体稳定性 | 核心使用 |
extent | 历史最大水体范围或曾经出现过水体的范围 | 核心使用,作为 max_extent 处理 |
seasonality | 一年内水体出现月份数或季节性水体信息 | 可下载,当前不是核心后处理输入 |
transitions | 水体状态变化类型 | 可下载,当前不是核心后处理输入 |
change | 水体变化强度或变化趋势相关产品 | 下载器支持,当前不是核心后处理输入 |
当前中国范围数据下载记录显示,按中国生态分区外包范围可覆盖约 35 个 10 度瓦片,已下载的产品包括 seasonality、occurrence、recurrence、transitions 和 extent。其中正式模型后处理核心使用 occurrence、recurrence 和 extent 三类。
JRC GSW 各产品字段含义如下。不同平台或版本的名称可能略有差异,但核心解释一致:
| 字段/产品 | 取值范围 | 字段含义 | 生态分类解释 |
|---|---|---|---|
occurrence | 0-100,无效值通常为 255 | 在全部有效观测中被识别为水体的比例,表示长期水体出现频率 | 数值越高,越接近长期稳定水体;低值可能表示临时积水、季节性水体、岸线过渡或偶发水体 |
change | 通常为百分比变化值或变化强度编码 | 比较早期和近期两个时期水体出现频率的变化 | 可辅助判断水体扩张、萎缩或长期变化,但不作为当前核心后处理输入 |
seasonality | 0-12,无效值通常为 255 | 一年中被识别为水体的月份数量 | 高值表示全年或长时间有水,低值表示季节性水体、洪泛区或短期积水 |
recurrence | 0-100,无效值通常为 255 | 在有水年份中水体重复出现的程度,强调水体跨年份的稳定性 | 与 occurrence 联合判断稳定水体;高 recurrence 说明该位置在有观测年份中反复出现水体 |
transitions | 离散类别编码 | 水体状态变化类别,例如永久水体、新增永久水体、消失永久水体、季节性变化等 | 可用于变化诊断和解释水体长期演变,当前不作为基础分类模型输入 |
extent | 通常为 0/1 或有效/无效编码 | 历史观测期内是否曾经被识别为水体,即最大水体范围 | 本项目转为 max_extent 使用,用于判断历史水体范围、消落带、河岸湖岸过渡区和“从未有水却被预测为水体”的冲突 |
其中,occurrence 和 recurrence 都是百分值,但含义不同。occurrence 更强调像元在全部有效观测中的总体有水频率;recurrence 更强调水体是否在多年中反复出现。一个像元可能 occurrence 不高但 extent=1,表示它历史上曾经被水覆盖,但不是长期稳定水体;这种区域在生态分类中常对应岸线、消落带、季节性河滩、湿地边缘或临时积水区。
seasonality 和 recurrence 也不同。seasonality 关注一年内有水月份数,表达季节内持续时间;recurrence 关注跨年份重复性,表达多年稳定性。对于生态分类后处理,稳定水体更适合用 occurrence + recurrence 共同约束,而季节性湿地或消落带可结合 extent、occurrence 和到稳定水体距离判断。
JRC 数据中的无效值通常需要单独处理。多数产品使用 255 表示无数据、无有效观测或产品无效区域。进行重采样、阈值判断和距离计算前,应先把无效值排除,否则会把无效区域误判为高值水体或普通陆地。
数据制参考文献
Jean-Francois Pekel, Andrew Cottam, Noel Gorelick, Alan S. Belward, High-resolution mapping of global surface water and its long-term changes. Nature 540, 418-422 (2016). (doi:10.1038/nature20584)
如何使用
JRC 当前主要用于模型后处理和 QA,而不是普通训练标签。它可以辅助判断稳定水体、季节性水域、历史水体范围、距离稳定水体的空间关系,并约束水体相关类别的拓扑一致性。
理论上,JRC 的 occurrence、recurrence、extent 或 max_extent 等产品可用于构建水体先验和空间规则。例如,长期高 occurrence 区域更可能是稳定水体;低 occurrence 但位于 max_extent 范围内的区域可能与季节性水域、滩涂或消落带有关。使用时应保持证据约束原则,即 JRC 作为辅助判断,不直接替代生态分类模型输出。
当前模型中,JRC 数据形成以下派生变量:
| 派生变量 | 来源 | 含义 |
|---|---|---|
jrc_occurrence | occurrence | 像元长期水体出现频率 |
jrc_recurrence | recurrence | 像元长期水体重复出现程度 |
jrc_max_extent | extent | 历史是否曾经属于水体范围,通常转为 0/1 |
jrc_valid | 三类核心产品有效性 | JRC 数据是否有效 |
jrc_stable_water | occurrence + recurrence | 稳定水体掩膜 |
jrc_intermittent_zone | extent + occurrence | 历史水体范围内的间歇性或低频水域 |
distance_to_jrc_stable_water_m | 稳定水体掩膜 | 到稳定水体的距离 |
distance_to_jrc_max_extent_m | 最大水体范围 | 到历史最大水体范围的距离 |
稳定水体的默认判据为:
occurrence >= 90
recurrence >= 90
间歇性水域或岸线过渡区通常结合 max_extent == 1 和较低 occurrence 判断。当前后处理中还使用 occurrence < 50 识别岸线/消落带倾向区域,使用 occurrence < 70 和距稳定水体一定距离识别河岸、湖岸或湿地过渡候选区域。这些阈值不是生态标签,而是水文证据规则,应结合模型概率和空间 QA 使用。
在空间对齐上,occurrence 和 recurrence 是连续百分值,可按连续变量方式重采样;extent/max_extent 是分类或二值范围证据,应使用最近邻或众数规则。所有 JRC 派生层必须与预测分类图保持同一 CRS、transform、shape 和像元大小。
JRC 后处理主要解决以下问题:
- 稳定水体被初始模型错分为非水体时,结合模型水体概率进行增强或修正。
- 历史从未出现水体的位置却被预测为水体时,记录冲突标记。
- 同一连续静水体内部出现
4201/4202混合时,按连通斑块进行一致性统一。 - 岸线、消落带、河岸湿地和城市绿地混淆区域,结合 JRC 水体距离和 EMC-BUILT 建成环境证据进行判断。
- 输出后处理 flags 和 QC 信息,保留哪些像元被 JRC 证据影响的可追踪记录。
如何下载
JRC Global Surface Water 理论上应从 JRC 官方数据页面、Google Earth Engine 或其他开放地理数据平台获取。下载时应确认产品版本、产品类型、时间覆盖范围、空间分辨率、坐标系统和数据许可。
由于 JRC 各产品含义不同,下载时应根据后处理目标选择 occurrence、recurrence、seasonality、extent、max_extent 等产品,并保留产品说明和编码定义。
当前下载路线使用 JRC GSW v1.5 2024 的公开 GeoTIFF 瓦片服务。理论下载步骤为:先确定研究区经纬度外包范围,再按 10 度网格计算相交瓦片,最后对每个瓦片分别获取所需产品。全国或大区域下载时,应按产品分目录保存,并记录产品版本、瓦片范围、下载时间和缺失瓦片情况。
下载时需要特别注意 JRC 瓦片纬度命名规则:文件名中的纬度值通常表示瓦片北缘。例如 30N 不是表示 30N-40N,而是表示 20N-30N。这一点会影响瓦片选择,尤其是研究区位于 20N-30N、30N-40N 等边界附近时。
对于本模型,最小必要下载产品是:
occurrence
recurrence
extent
如果后续需要更细的季节性水体分析或水体变化诊断,可同时下载:
seasonality
transitions
change
JRC数据可以从google earth enginer上直接使用。
EMC-BUILT 人工硬化和绿化数据
数据介绍
EMC-BUILT 是用于描述建成环境或建筑相关空间格局的辅助数据。它可以提供居民地、非居民地、建成区强度或建成环境绿度等信息。对于生态分类中的城市绿地、城市草本绿地、人工地表周边植被等类别,单纯光谱上可能与普通草地、农田或裸地混淆,因此需要建成环境证据辅助判断。
当前模型使用 EMC-BUILT 的重点不是识别所有建设用地,而是为“城市绿地类”提供人工建成环境背景证据。以 6206 城市草本绿地 为例,类别关键词不是“草本”本身,而是“城市”。一个像元即使在 Sentinel-2 光谱上表现为草本植被,如果它远离居民地、道路、建筑或人工建成环境,就不应轻易解释为城市草本绿地。
当前涉及两类 EMC-BUILT 数据:
| 数据 | 含义 | 当前用途 |
|---|---|---|
| EMC-BUILT Total RES+NRES | 居民地和非居民地建成表面总量,可理解为建成环境强度或建成面积证据 | 核心使用,用于派生建成比例、建成掩膜、建成环境距离和邻域建成强度 |
| EMC-BUILT Greenness | 建成环境中的绿度或绿化相关信号 | 辅助使用,用于判断城市绿地解释是否具备建成环境绿度背景 |
其中,RES 可理解为 residential built-up,即居民地相关建成表面;NRES 可理解为 non-residential built-up,即非居民地或非住宅类建成表面。二者相加形成 Total RES+NRES,用于表达人工建成环境总体强度。
字段与派生变量说明
EMC-BUILT 原始 Total 数据通常表达每个高分辨率像元内的建成表面面积或建成强度。当前理论处理方式是将高分辨率建成面积汇总到模型目标 30m 网格,并转化为 0-1 的建成比例。
当前模型使用或派生的主要字段如下:
| 字段/派生层 | 取值 | 含义 | 生态分类解释 |
|---|---|---|---|
emc_built_fraction_30m | 0-1 | 30m 像元内建成表面比例 | 数值越高,说明该像元越接近人工建成环境 |
emc_built_area_30m | 面积值 | 30m 像元内估算建成面积 | 可用于解释建成强度,但当前后处理主要使用比例 |
emc_built_mask_30m | 0/1 | 根据建成比例阈值得到的建成环境掩膜 | 用于计算到建成环境的距离 |
distance_to_emc_built | 米 | 到最近建成环境掩膜像元的距离 | 判断某个草本/绿地像元是否处于城市或人工环境附近 |
emc_built_fraction_300m | 0-1 | 约 300m 邻域内平均建成比例 | 表达周边建成环境背景,而不是只看单个像元 |
emc_valid_30m | 0/1 | EMC-BUILT Total 数据是否有效 | 避免无效区被误判为低建成环境 |
emc_greenness_30m | 连续值 | EMC-BUILT Greenness 对齐结果 | 表示建成环境绿度或绿化相关证据 |
emc_greenness_valid_30m | 0/1 | Greenness 数据是否有效 | 用于判断城市绿地类是否有建成环境绿度证据支持 |
当前建成环境掩膜的默认判断思路是:当 emc_built_fraction_30m 达到一定比例时,将该像元视为建成环境候选。现有后处理默认使用 0.05 作为建成比例阈值,即 30m 像元内建成表面比例达到 5% 时,可作为距离计算的建成环境掩膜。这个阈值是空间语义约束参数,不是生态分类标签。
300m 邻域建成比例用于弥补单像元判断的局限。城市绿地可能位于公园、道路绿带、居住区边缘或建设用地内部,单个 30m 像元本身未必有很高建成比例,但周围 300m 范围内应具有一定人工建成环境背景。因此,emc_built_fraction_300m 比单像元比例更适合判断城市语义。
如何使用
EMC-BUILT 主要用于后处理和空间语义约束。理论上,可以从建成环境数据中派生建成区比例、到建成区距离、邻域建成区强度和建成环境绿度等变量,用于判断某些绿地类别是否真正处于城市或人工建成环境背景中。
使用时应避免把建成环境数据简单作为生态标签。它只能说明人工环境背景和空间邻近关系,不能独立决定生态类型。例如,一个像元光谱像草地,但只有当其位于建成区内部或周边,并满足一定空间条件时,才可能被解释为城市绿地相关类别。
当前模型中,EMC-BUILT 与 JRC 水体证据联合使用,重点约束 6206 城市草本绿地 及相关城市绿地类。典型判断逻辑如下:
- 如果某个像元被初始模型预测为城市草本绿地,但它靠近稳定水体、位于历史最大水体范围内,且远离 EMC-BUILT 建成环境,则该像元更可能是岸线、消落带、湿地边缘或水体周边草本,而不是城市草本绿地。
- 如果某个像元具备较强 EMC-BUILT 建成比例、距离建成环境较近,或 300m 邻域建成比例较高,同时 Greenness 信号有效,则保留城市绿地解释更有依据。
- 如果 JRC 显示该区域具有明显水体或历史水体背景,而 EMC-BUILT 显示缺乏人工建成环境背景,则后处理应对城市绿地类进行标记,必要时结合模型概率改判为更合理的岸线、湿地、草地或水体相关类别。
当前后处理使用的核心阈值包括:
| 参数 | 默认值 | 含义 |
|---|---|---|
emc_built_mask_fraction | 0.05 | 建成比例达到 5% 时视为建成环境候选 |
emc_built_far_distance | 300m | 距建成环境超过该距离时,可认为远离人工环境 |
emc_built_keep_distance | 150m | 距建成环境较近时,更倾向保留城市绿地解释 |
emc_built_low_neighborhood | 0.001 | 300m 邻域建成比例极低时,说明周边缺少建成环境背景 |
emc_built_keep_neighborhood | 0.005 | 300m 邻域建成比例达到一定水平时,支持城市绿地解释 |
这些阈值用于后处理 QA 和空间语义约束,不代表 EMC-BUILT 自身的分类标准,也不应作为固定不变的全国生态规则。不同城市密度、乡村聚落、山地城镇和干旱区绿洲环境中,阈值可能需要通过代表性 tile 做 QA 后微调。
在重采样和对齐方面,EMC-BUILT Total 属于连续面积或比例型数据,汇总到 30m 网格时应采用面积平均或比例平均;建成环境掩膜、有效性掩膜属于二值/分类结果,应使用最近邻或基于比例阈值重新生成。Greenness 属于连续或指数型信号,可按连续变量处理,但必须保留有效性掩膜,避免无效区被误解释为低绿度。
如何下载
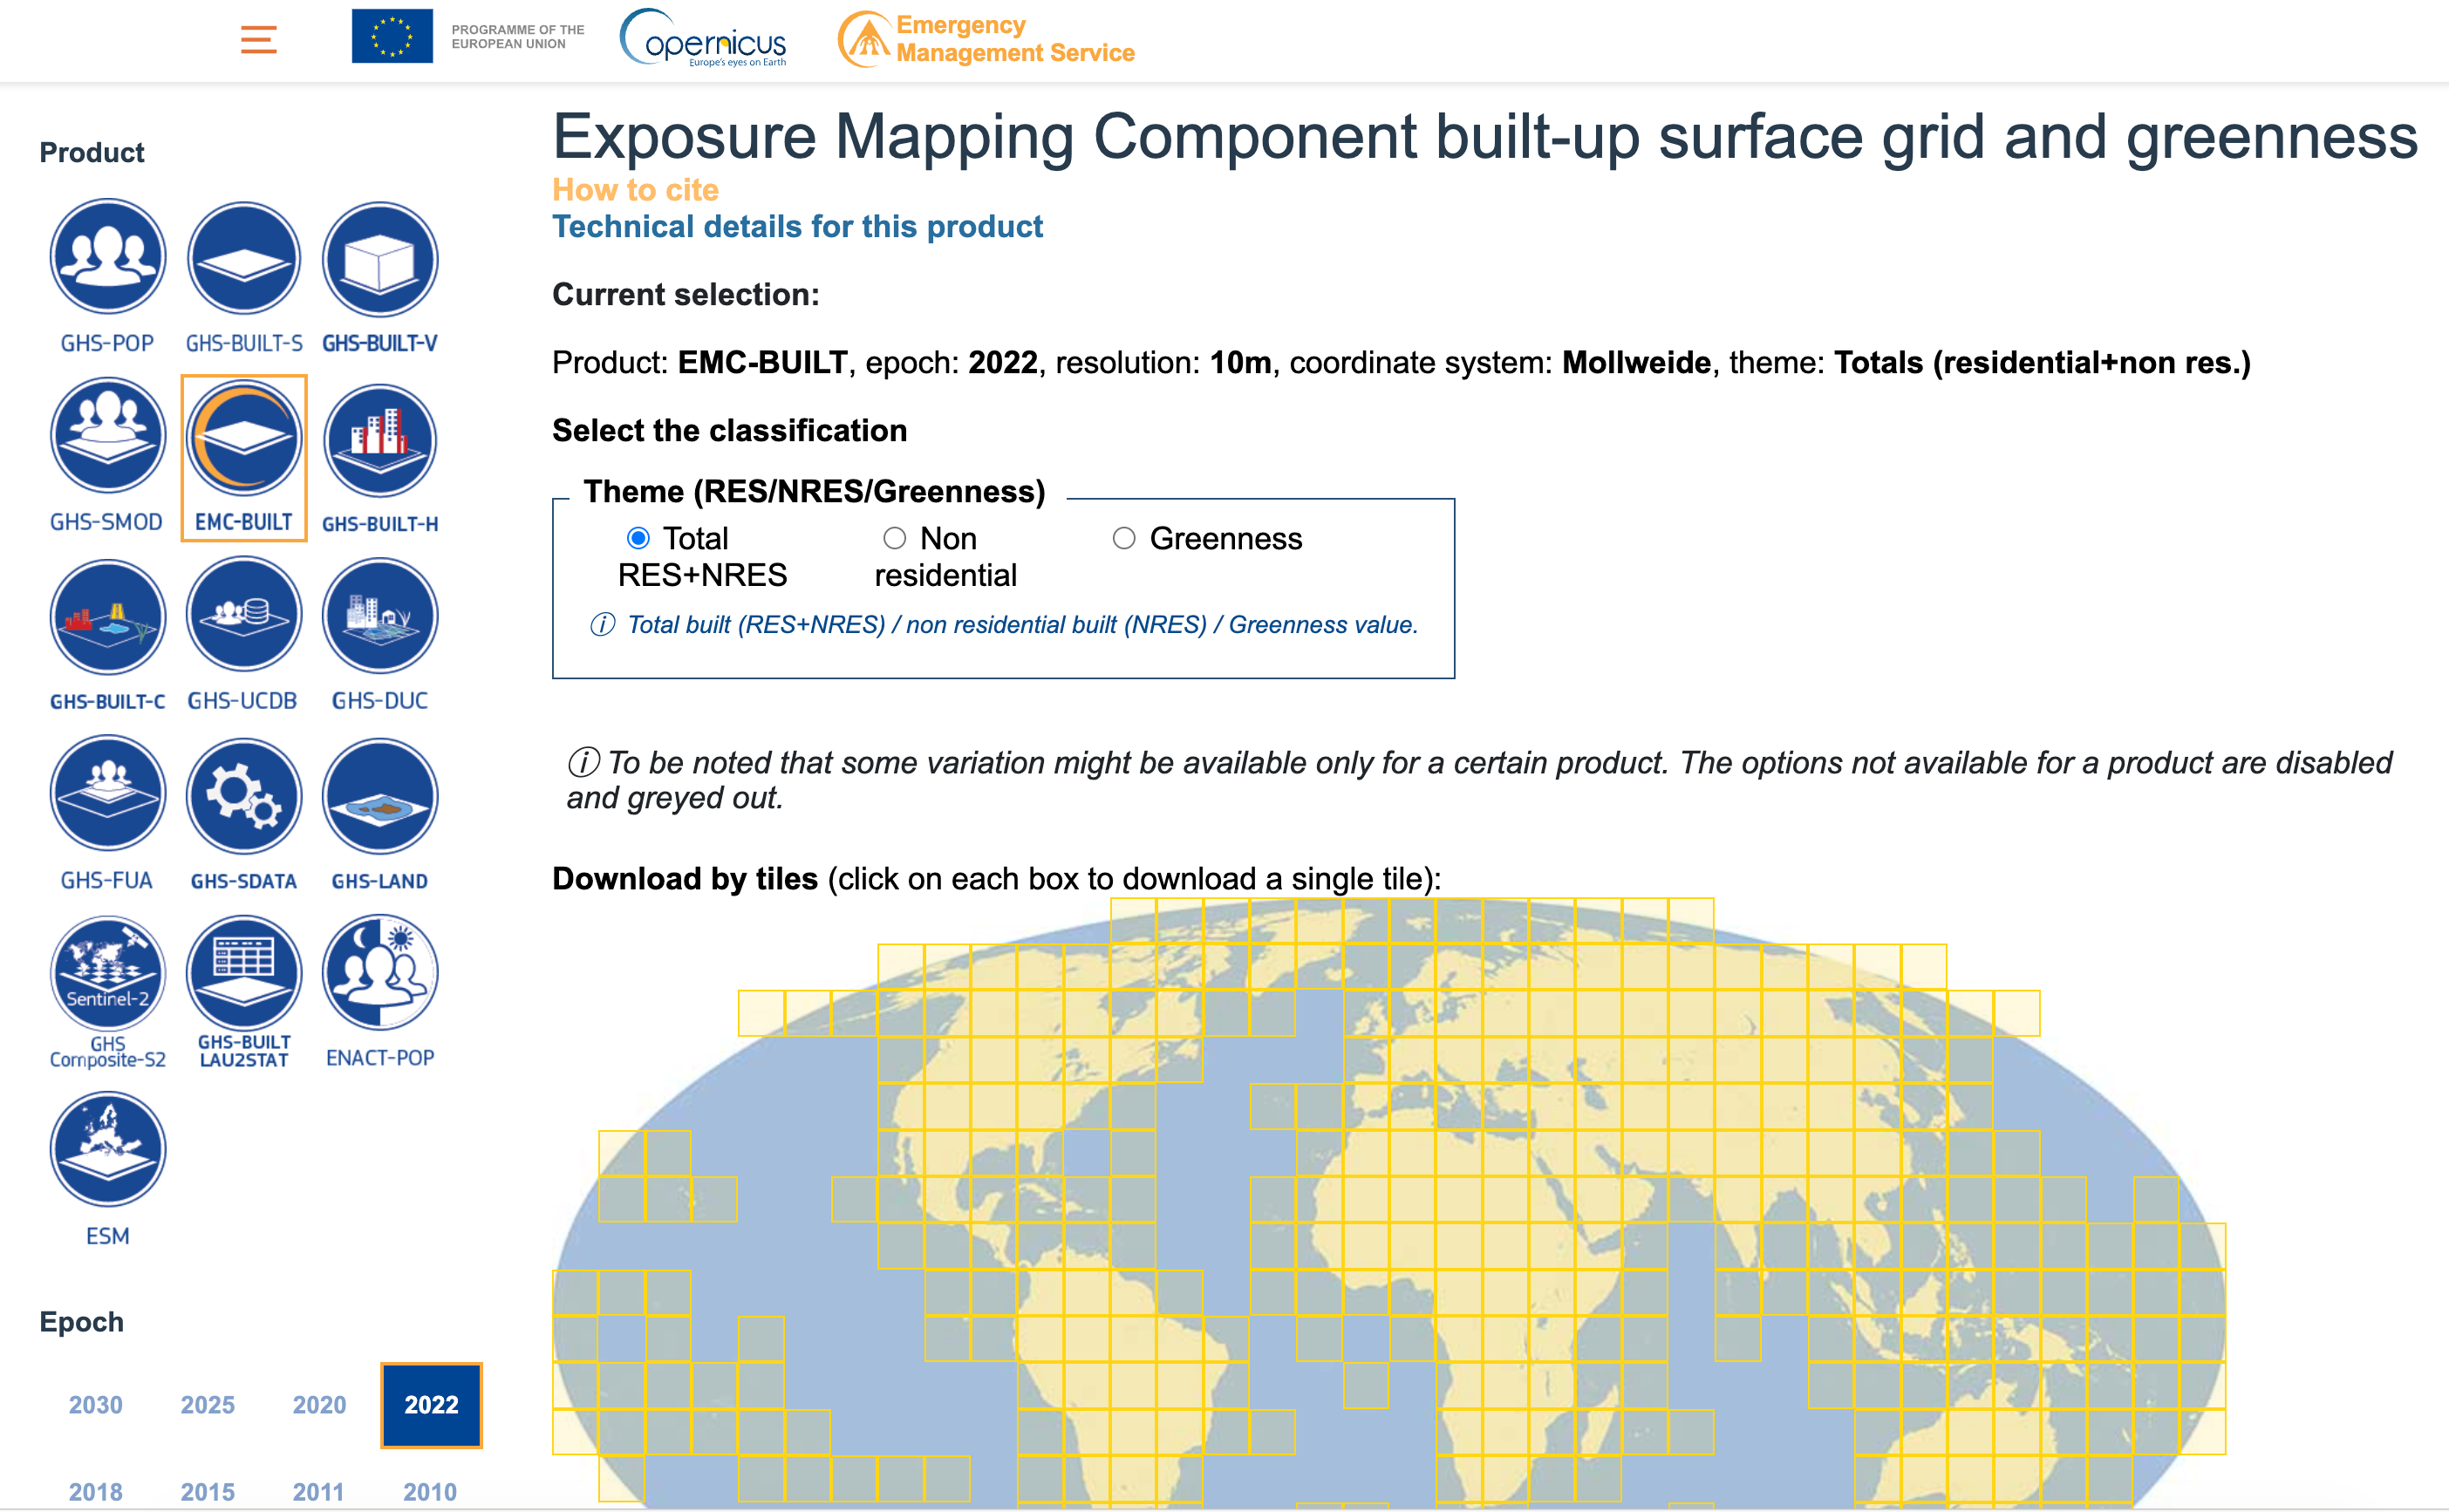
EMC-BUILT 类数据应从其哥白尼应急管理服务(Copernicus Emergency Management Service, CEMS)发布平台、论文配套数据仓库或开放地理数据平台获取。下载时应确认产品年份、空间分辨率、变量含义、建筑/建成区定义、数据格式和使用许可。
若使用多个建成环境产品,应统一年份、空间参考和类别定义,并记录不同产品在城市、乡村、工业区和绿地边界上的定义差异。
理论下载时至少需要区分两类数据目录或产品:
EMC-BUILT Total RES+NRES
EMC-BUILT Greenness
下载后应检查:
- 产品年份是否与预测年份或后处理目标一致。
- Total 数据是否同时包含居民地和非居民地建成表面,或是否需要自行合并 RES 与 NRES。
- Greenness 数据的取值含义、有效范围和 NoData 定义是否清楚。
- 原始数据空间分辨率、坐标系统、瓦片编号和覆盖范围是否完整。
- 是否允许在生态分类模型后处理和成果生产中使用。
由于 EMC-BUILT 是辅助证据,不是生态标签,下载和使用时最重要的是记录版本、年份、变量定义和有效值规则。若后续更换为其他建成环境产品,例如不透水面比例、建筑物 footprint、GISA/GHSL/World Settlement Footprint 等,应重新验证城市绿地后处理规则,不能直接沿用原阈值。
数据准备原则小结
生态再分类模型的数据准备应遵守以下原则:
- 生态分类标签只用于监督训练,不被 Sentinel-2、ESA、JRC、EMC-BUILT 替代。
- Sentinel-2 是主要动态预测特征,应按季节合成并保证训练推理字段一致。
- DEM 和 HWSD 是稳定环境背景特征,表达地形和土壤生态位条件。
- ESA 用于外部土地覆盖证据,不能直接当生态分类标签。
- JRC 和 EMC-BUILT 更适合后处理和 QA,用于解决水体拓扑和建成环境语义问题。
- 连续变量可采用连续型重采样,分类编码变量必须使用最近邻或众数重采样。
- 所有数据都应记录来源、版本、年份、空间参考、分辨率、编码表和许可条件。