栅格序列计算
对多个栅格的对应位置逐像元统计,生成一张结果栅格。
功能说明
选择同一变量、空间范围和网格可对应的多个栅格,按选定方法计算每个位置的平均值、极值、分位数或其他统计量。结果是各输入对应像元的统计,不是对单张栅格的空间邻域统计。
参数说明
| 参数 | 说明 | 必填 | 默认值 |
|---|---|---|---|
| 输入多个栅格文件 | 至少两个栅格;顺序影响权重、极值位置及趋势结果。 | 是 | 空 |
| 统计方法 | 选择一种逐像元统计方法;还提供 mode、skewness、kurtosis 等选项。 | 是 | average |
| 分位数值 | 仅方法为 quantile 时使用,范围 0–1。 | 否 | 0.5 |
| 数据范围 | 输入 min,max;范围外值按空值处理,例如 0,100。 | 否 | 空 |
| 图层权重 | 英文逗号分隔;数量和顺序须与输入栅格一致,例如 1,2,1。 | 否 | 空 |
| 并行线程数 | 控制并行计算线程。 | 是 | 1 |
| 内存缓存(MB) | 栅格行缓存大小。 | 是 | 300 |
| 传播空值 | 启用后对应位置任一输入为空时输出空值。 | 否 | 关闭 |
| 不保持文件打开 | 大量输入时减少同时打开的文件数。 | 否 | 关闭 |
| 输出统计栅格 | 指定结果保存位置。 | 是 | 空 |
统计方法详解
下表中的“输入值”是同一个位置在各输入栅格中的像元值。例如三个栅格某位置的有效值依次为 2、4、6,则平均值为 4、最小值为 2、极差为 4。每次选择一种统计方法生成结果。
| 方法 | 含义与适用场景 | 输出解释 |
|---|---|---|
average | 算术平均值,用于了解序列的平均水平。 | 有效输入值的平均;通常与输入单位相同。 |
count | 有效值数量,用于检查参与统计的样本数量。 | 个数,不是像元值之和。 |
median | 中位数,用于描述序列中心,对极端值相对不敏感。 | 将有效值排序后居中的值。 |
mode | 众数,用于寻找最常出现的值,常见于离散类别。 | 出现频率最高的值;并列时应谨慎解释。 |
minimum | 最小值,用于寻找最低观测。 | 输入值中的最小值。 |
min_raster | 最小值所在栅格,用于定位极值来自哪一期。 | 输入栅格的索引,原生 GRASS 从 0 开始,不是最小值本身。 |
maximum | 最大值,用于寻找最高观测。 | 输入值中的最大值。 |
max_raster | 最大值所在栅格,用于定位极值来自哪一期。 | 输入栅格的索引,原生 GRASS 从 0 开始,不是最大值本身。 |
stddev | 标准差,用于衡量序列值围绕平均值的离散程度。 | 值越大通常表示波动越大,单位与输入相同。 |
range | 极差,用于比较最高与最低值的差异。 | 最大值减最小值,单位与输入相同。 |
sum | 求和,用于统计具有可相加含义的序列值。 | 输入值之和;能否解释为时段总量取决于输入单位和时间含义。 |
variance | 方差,用于衡量离散程度。 | 单位为输入单位的平方,不与标准差直接比较数值。 |
diversity | 不同值的个数,用于统计类别或取值多样性。 | 不同数值的数量,不是有效样本总数。 |
slope | 线性回归斜率,用于观察按输入顺序的线性变化趋势。 | 正值表示上升趋势,负值表示下降趋势;尺度与序列间隔有关。 |
offset | 线性回归截距,与斜率共同描述拟合直线。 | 回归序列索引为 0 时的估计值,不一定等于第一期实际值。 |
detcoeff | 线性回归决定系数,用于了解线性拟合程度。 | 通常在 0–1 之间,越接近 1 表示拟合程度越高;不代表因果关系。 |
tvalue | 回归斜率的 t 统计量,用于辅助评价线性趋势。 | 不是斜率、概率或 p 值;解释还需考虑样本量和统计假设。 |
quart1 | 第一四分位数,用于观察较低部分的分布。 | 约 25% 分位位置的值。 |
quart3 | 第三四分位数,用于观察较高部分的分布。 | 约 75% 分位位置的值。 |
perc90 | 第 90 百分位数,用于观察较高值水平。 | 约 90% 分位位置的值,不是最大值。 |
quantile | 自定义分位数;配合“分位数值”选择所需位置。 | 参数范围为 0–1,例如 0.5 对应中位数位置。 |
skewness | 偏度,用于描述数值分布的不对称程度。 | 正负号反映偏斜方向;接近 0 通常表示较对称。 |
kurtosis | 峰度,用于描述分布形状及尾部特征。 | 解释时应注意所用定义与样本量,不应直接等同于极值。 |
min_raster 和 max_raster 的索引对应输入顺序:第一张为 0,第二张为 1,依此类推;如需解释为日期,应先建立索引与日期的对应关系。回归方法将输入视为等间隔序列,因此应按时间顺序输入;对于不等间隔观测,不能将输出斜率直接当作按实际时间计算的变化率。权重、数据范围和空值设置会影响参与计算的值,应根据分析目标核对。
典型应用
| 目标 | 统计方法 | 选择提示 |
|---|---|---|
| 了解典型水平或累计值 | average、median、sum | 输入应具有可比较的变量和单位;月平均与月总量的物理意义不同。 |
| 找极值和变化范围 | minimum、maximum、range | range 为最大值减最小值;min_raster、max_raster 则返回对应输入的序号,不是极值本身。 |
| 统计样本或离散程度 | count、stddev、variance、diversity | count 统计有效像元个数,diversity 统计不同值的个数。 |
| 按序列分析变化趋势 | slope、offset、detcoeff、tvalue | 顺序应对应序列顺序;原生回归假设输入间隔相等,斜率不能直接当作不等时间间隔的年变化率。 |
| 计算特定分位数 | quart1、quart3、perc90、quantile | 自定义 quantile 时填写 0–1 之间的分位数值。 |
输出结果
输出一张统计栅格。像元值及单位取决于所选方法:平均值与输入单位相同,计数为个数;极值位置方法输出输入顺序索引,GRASS 原生索引从 0 开始。默认多数方法忽略空值;勾选传播空值后则任一输入为空即输出空值。
使用步骤
- 打开【计算工具箱】→【GRASS GIS】→【栅格工具】→【序列分析】→【栅格序列计算】。
- 按顺序选择输入栅格,选择统计方法,按需设置权重、范围和空值选项。
- 指定输出栅格并运行。
使用示例
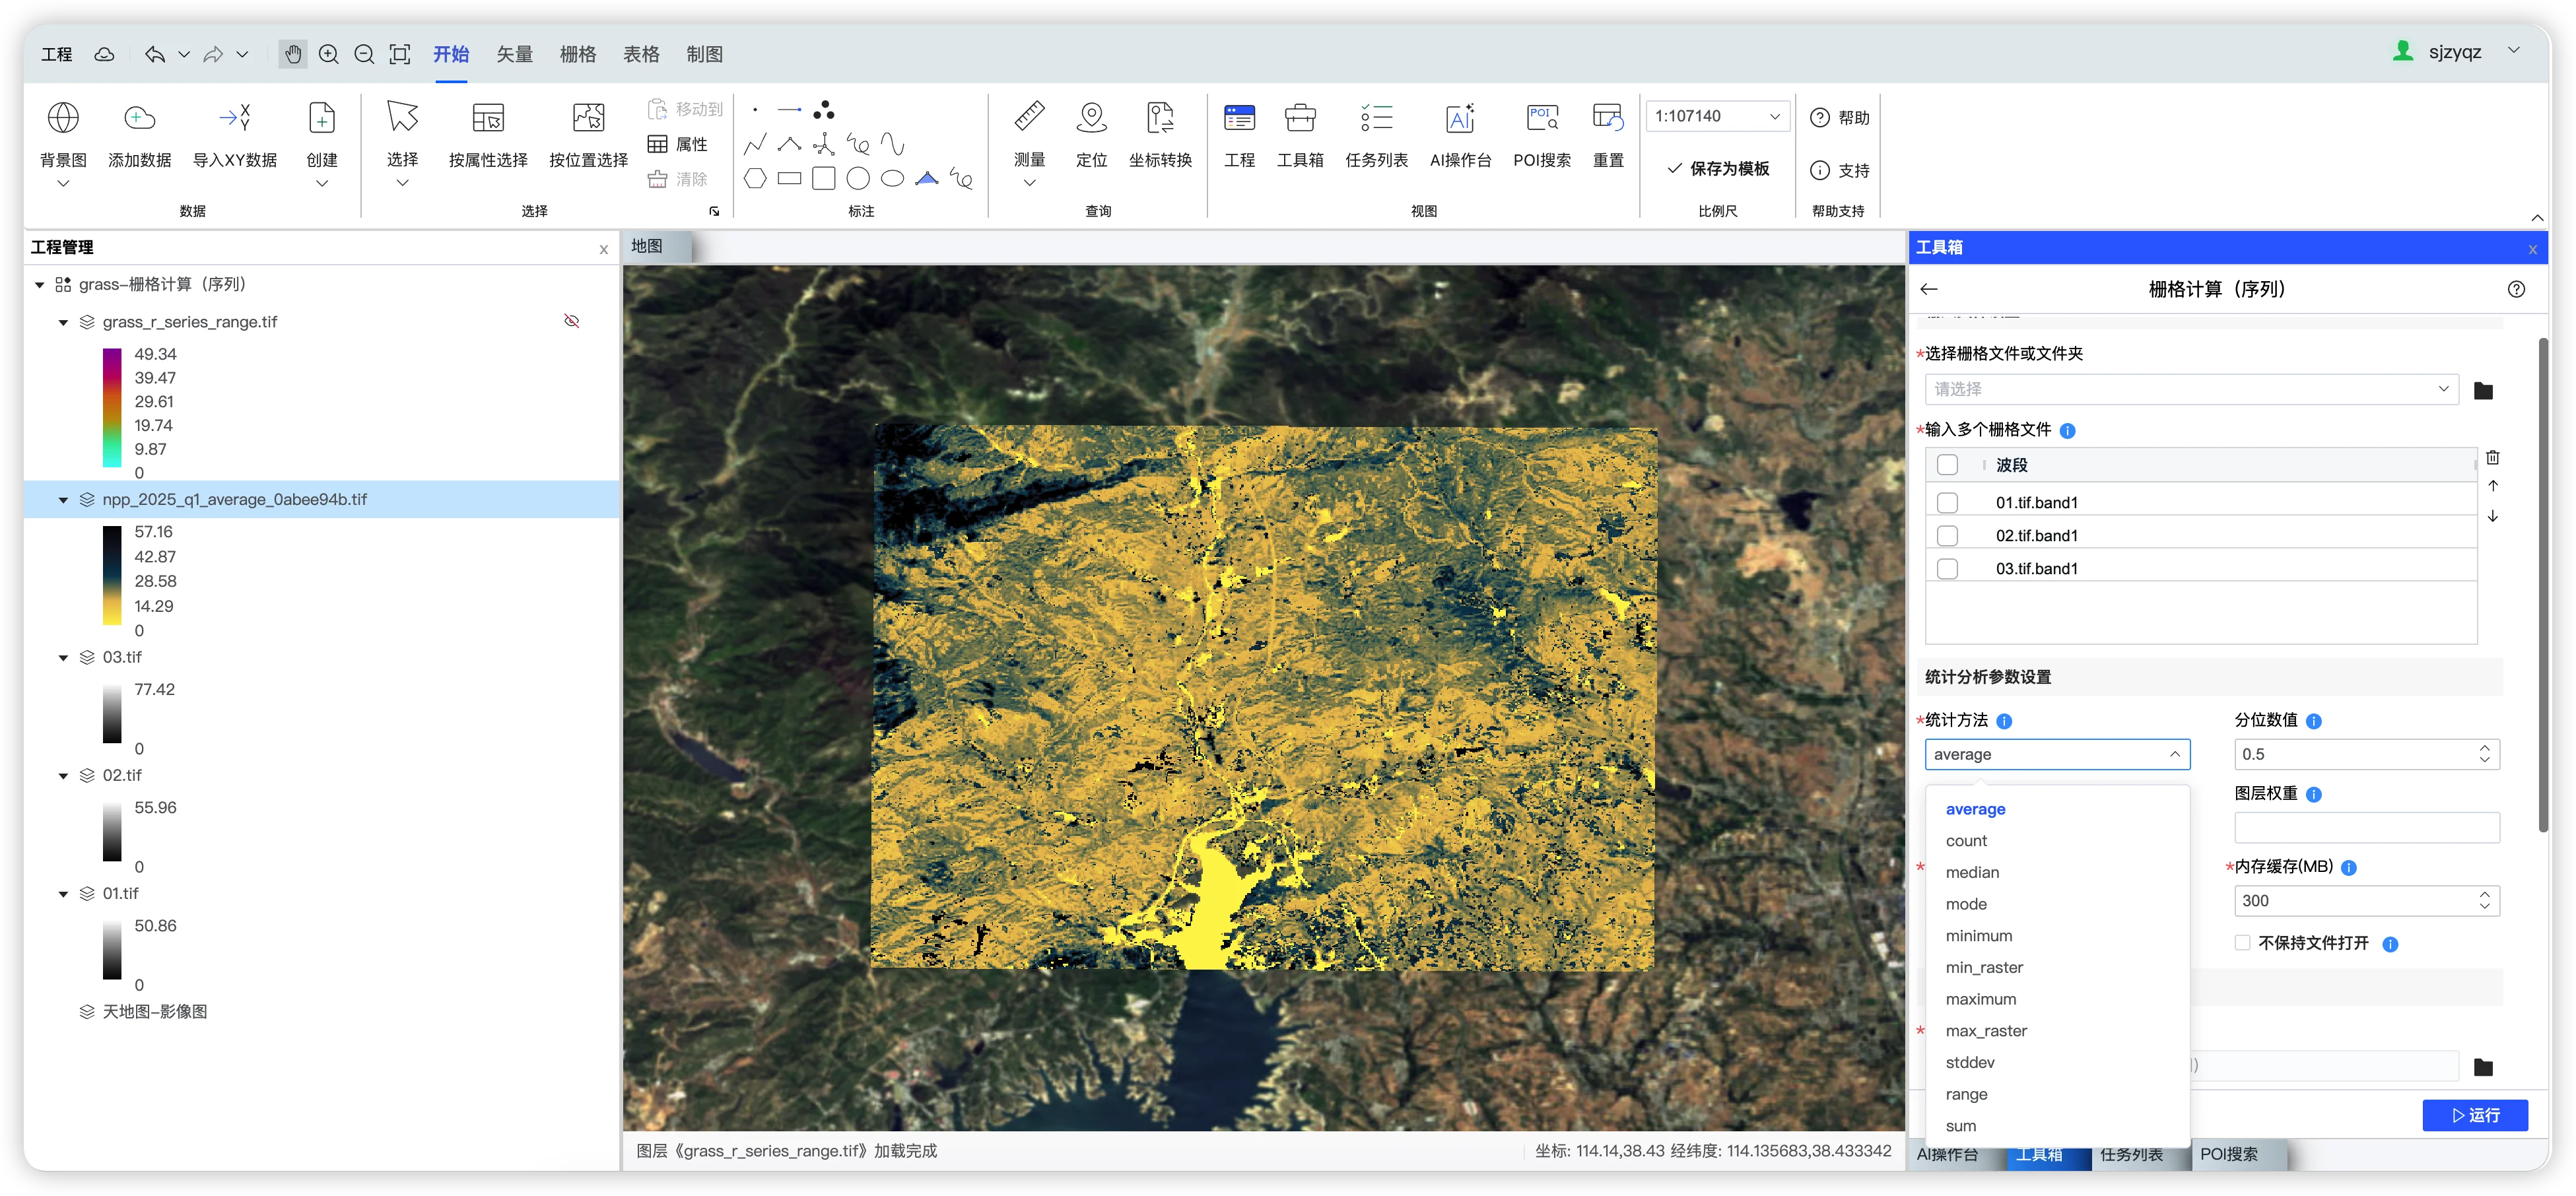
示例项目 grass-栅格计算(序列) 依次使用平山样区 2025 年 1、2、3 月 NPP 栅格 01.tif、02.tif、03.tif,选 average,其余保持默认,用于比较第一季度各月的平均月度 NPP。输出 npp_2025_q1_average_0abee94b.tif 为 EPSG:3857、599 × 531 像元;项目统计有效值约为 0–57.16。输入为月度 NPP,单位为 g C/m²/月;平均月度值不是季度累计量。
注意事项
- 确保输入变量、单位和网格具有可比性;输入顺序应与权重顺序一致。
- 范围过滤会影响有效样本数;传播空值可用于要求每个输入均有效的分析。
- 回归结果、极值索引和各统计量的含义不同,不能互换解释。
相关工具
- 计算栅格插值:在已知序列位置之间估算新栅格。
- 计算栅格累积量:基于指定方法计算累积值。
技术参考
GRASS GIS 原生模块 r.series。